
Der Issue-Grundlage-Skill: /issue-grundlage
Meine Grund-Hypothesen
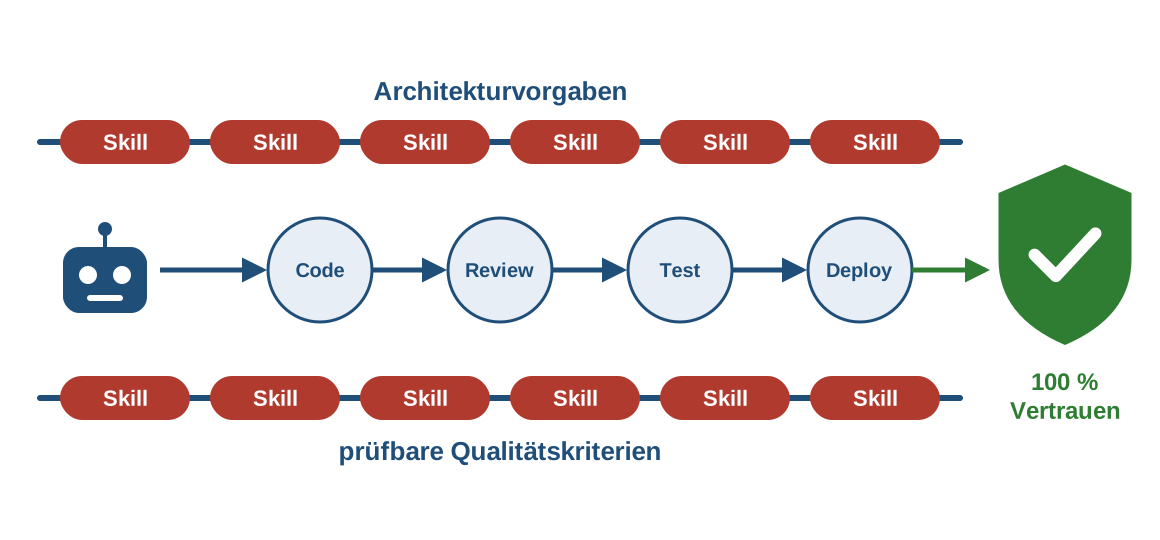
- Coding Agents sind inzwischen “schlau” genug, um die komplette Produktion des Codes inkl. Code-Review, Deployment etc. zu übernehmen
- das geht aber nicht “einfach so”
- Der Schlüssel sind Orchestrierung und Guard Rails in Form von z. B. Architekturvorgaben und prüfbaren Qualitätskriterien, die so engmaschig und zuverlässig sind, dass die Entwickler 100 % Vertrauen darin haben.
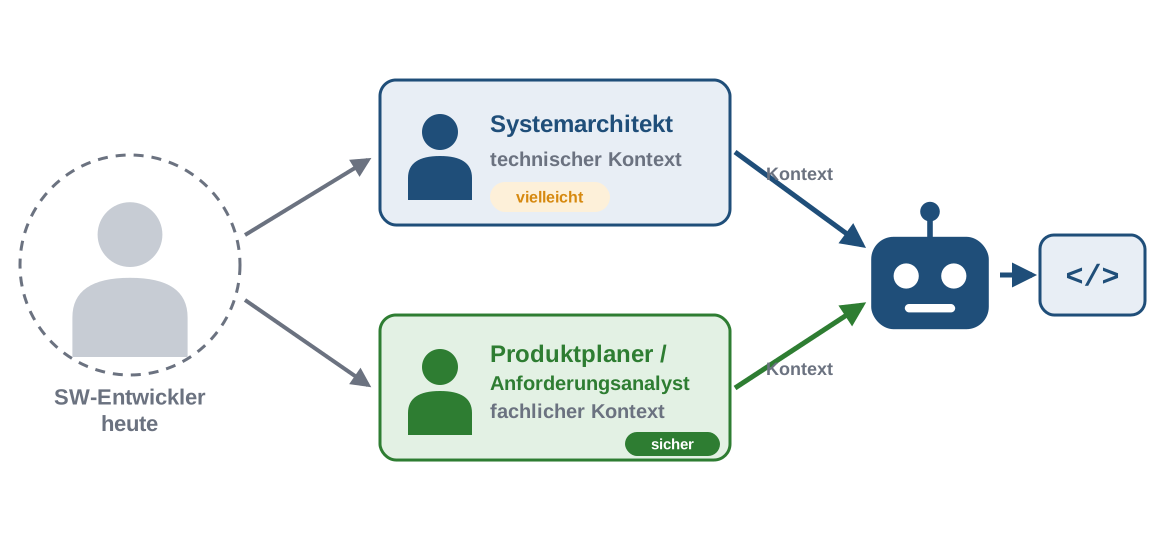
- provokante Hypothese: letztlich löst sich das Berufsbild des SW-Entwicklers auf.
- was bleibt, ist vielleicht der Systemarchitekt, der technischen Kontext und technische Anforderungen zusammenstellt
- und mit Sicherheit der Produktplaner/Anforderungsanalyst/Anwenderversteher, der den fachlichen Kontext zusammenstellt.
Mögliche Wege dorthin
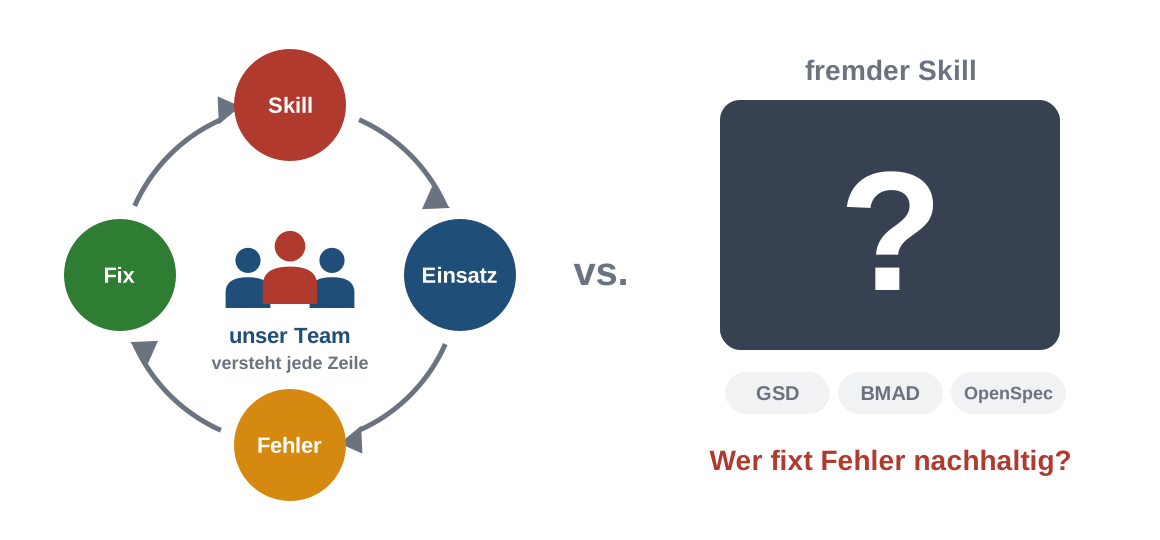
- Diese Architekturvorgaben und prüfbaren Qualitätskriterien sind als Skills realisiert, die aber NICHT von anderen übernommen, sondern vom selben Entwicklerteam selbst entwickelt und immer weiter verfeinert werden.
- in “fremde” Skills kann vielleicht noch ein einzelner Entwickler 100 % Vertrauen haben, aber was, wenn sich doch Fehler einschleichen? Wer fixt diese nachhaltig, sodass sie auch in Zukunft nicht mehr auftreten?
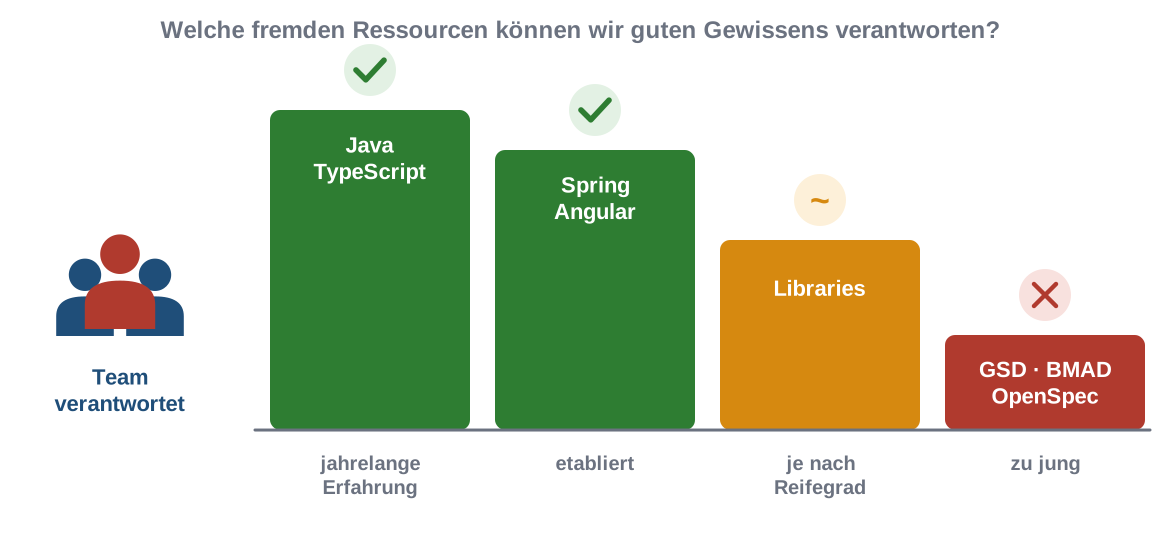
- Entwicklerteams sollen volle Verantwortung für erzeugten Code übernehmen. Welche fremden Ressourcen können sie guten Gewissens verantworten?
- etablierte Programmiersprachen (z. B. Java, TypeScript) sind ok, jahrelange gute Erfahrung
- etablierte Frameworks (Spring, Angular) ebenso
- sonstige zusätzliche Libraries sind, je nach Reifegrad und Community-Support, teilweise auch ok
- fremde Skillsets (GSD, BMAD, OpenSpec etc.) gibt es noch nicht lange genug, um ähnliches Vertrauen zu rechtfertigen. Ihr Reifegrad muss als unzureichend bewertet werden.
- “Fertige Skillsets” wie z. B. GSD, BMAD oder OpenSpec sind beeindruckend und funktionieren für mich bei kleineren Projekten, bei denen nicht viel auf dem Spiel steht. Aber für große Projekte habe ich (noch) kein hundertprozentiges Vertrauen.
- Daher: Skills müssen (jedenfalls derzeit noch) für größere, längerfristige Projekte von den Teams selbst entwickelt werden.
- Skills werden inkrementell verbessert
- Das Team sollte genau verstehen, was in den Skills drinsteht.
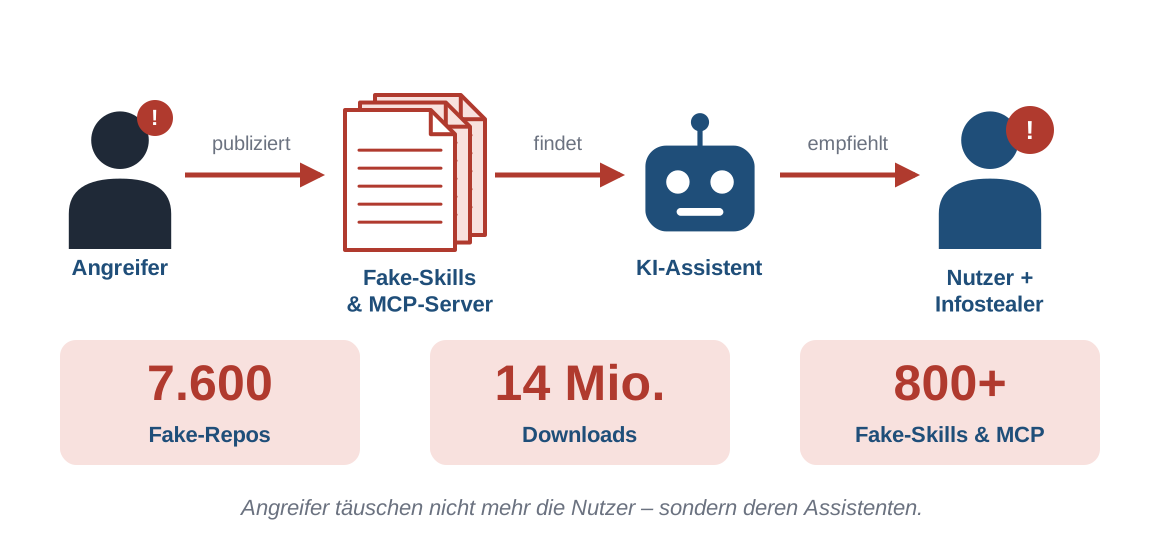
- Skills aus anderen Quellen sind potentiell extrem gefährlich:
- Roughly 7,600 fake GitHub repositories, 6,600 fraudulent profiles and more than 14 million downloads: that is the scale of FakeGit, a malware campaign documented by Island in July 2026. Over 800 repositories impersonated AI skills and MCP servers, distributing SmartLoader and the StealC infostealer.
- Fake repositories are nothing new. The surprise was who recommended them.
- Gemini and ChatGPT independently suggested the same malicious walmart-mcp repository. The agents found the attacker’s project and handed users installation instructions.
- Attackers no longer need to deceive users directly. They can deceive the assistants users trust.
Skills im Projekt
- wir haben viele Skills im Projekt, von unterschiedlichen Entwicklern, für die verschiedenen Entwicklungsstadien eines Features/Work Items/Issues.
- Anforderungsanalyse
- Planerstellung
- NICHT fürs eigentliche Coding: da reicht der Prompt: “setze Plan XY um”
- Qualitätssicherung und Code Review
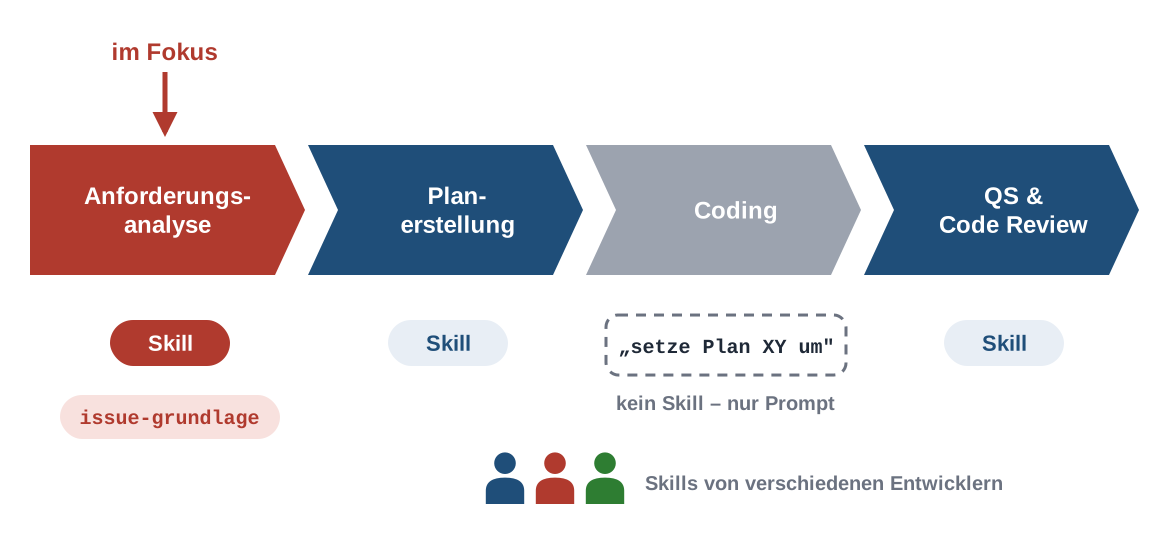
Im Folgenden besprechen wir nur den …:
Skill zur Anforderungsanalyse
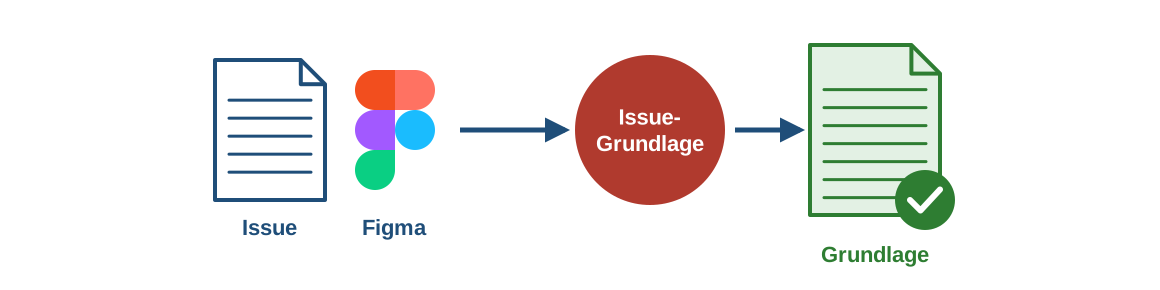
der Skill heißt bei uns “issue-grundlage”
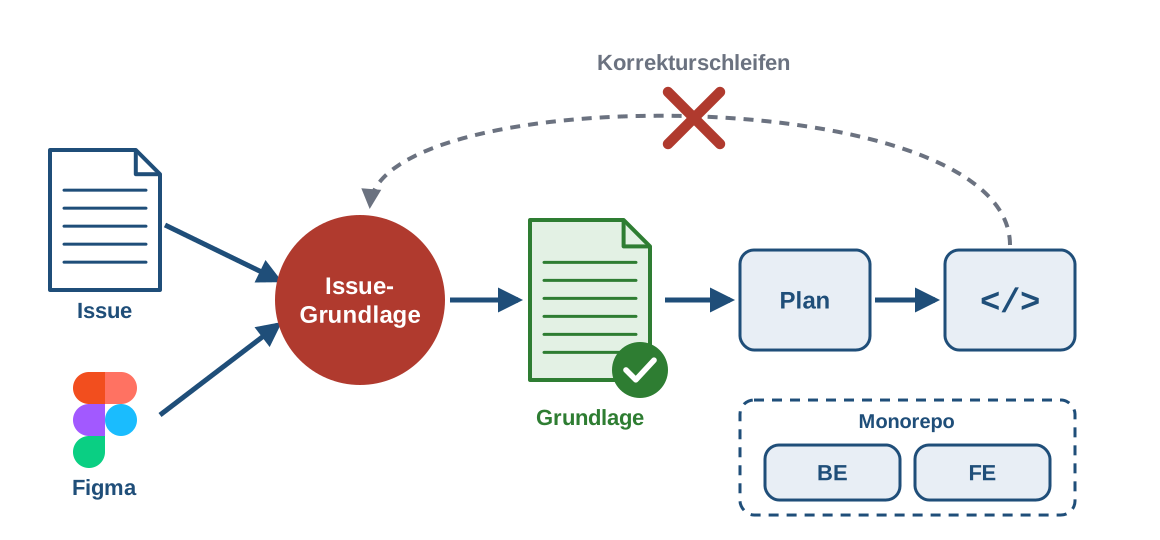
Korrekturschleifen vermeiden durch bessere Anforderungsanalyse
Um Korrekturschleifen zu vermeiden, haben wir den “Issue-Grundlage”-Skill iterativ entwickelt, der eine möglichst vollständige, umfassende und widerspruchsfreie Grundlage für die Planung eines Features (Work Item/Issue) liefern soll, sodass Planerstellung und Umsetzung ohne weitere Rückfragen vom Coding Agent durchgeführt werden können.
Voraussetzung: Monorepo für BE UND FE, eine Trennung von beiden macht m. E. für Coding Agents keinen Sinn
Ausgangssituation:
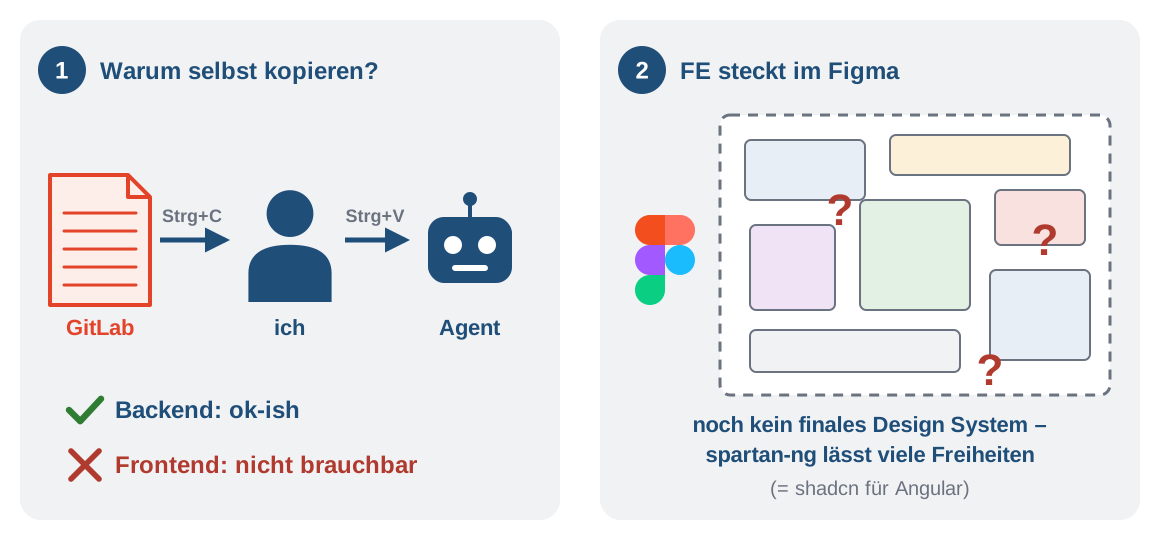
Ich kopiere den Issue-Text aus GitLab in den Prompt. Funktioniert für reine Backend-Tasks ok-ish, aber nicht für Frontend.
Das Problem
-
Warum selber kopieren? Kann doch der Coding Agent auch!
-
Problem: Anforderungen für FE liegen größtenteils im Figma. Aber: Wir haben (noch) kein fertiges Design System, sondern nur die Entscheidung, “spartan-ng” zu verwenden. “Spartan-ng” ist ein “shadcn”-Komponentenset für Angular.
Einschub: Shadcn:
shadcn/ui is a set of beautifully-designed, accessible components and a code distribution platform. Works with your favorite frameworks and AI models. Open Source. Open Code.
This is not a component library. It is how you build your component library.
Lösung
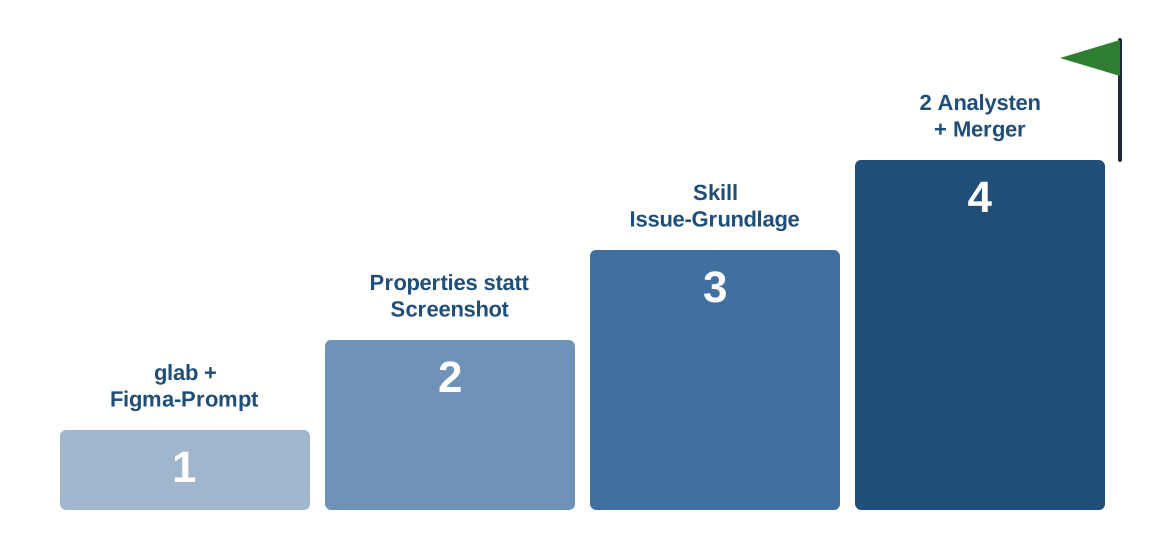
Iteration 1
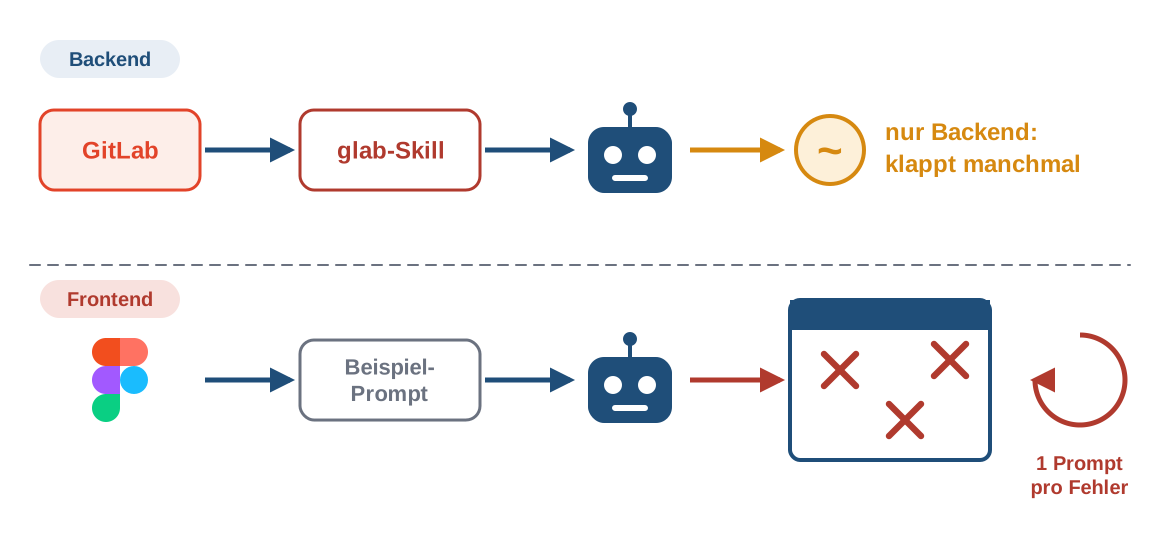
- Skill für GitLab, basierend auf der
glab-CLI - Figma Dev Mode + Figma-MCP-Server + Figma-Funktion “Beispiel-Prompt kopieren”: den Prompt mit Link in meinen Prompt kopieren
Jedoch:
- Skill für GitLab läuft
- Aber: Der Figma-Beispielprompt bringt noch nicht die Details für FE wie gewünscht: FE hat viele Fehler, die alle nachgebessert werden müssen – zwar nicht manuell, aber mit je einem Prompt pro Problem, was viel Arbeit macht
Iteration 2
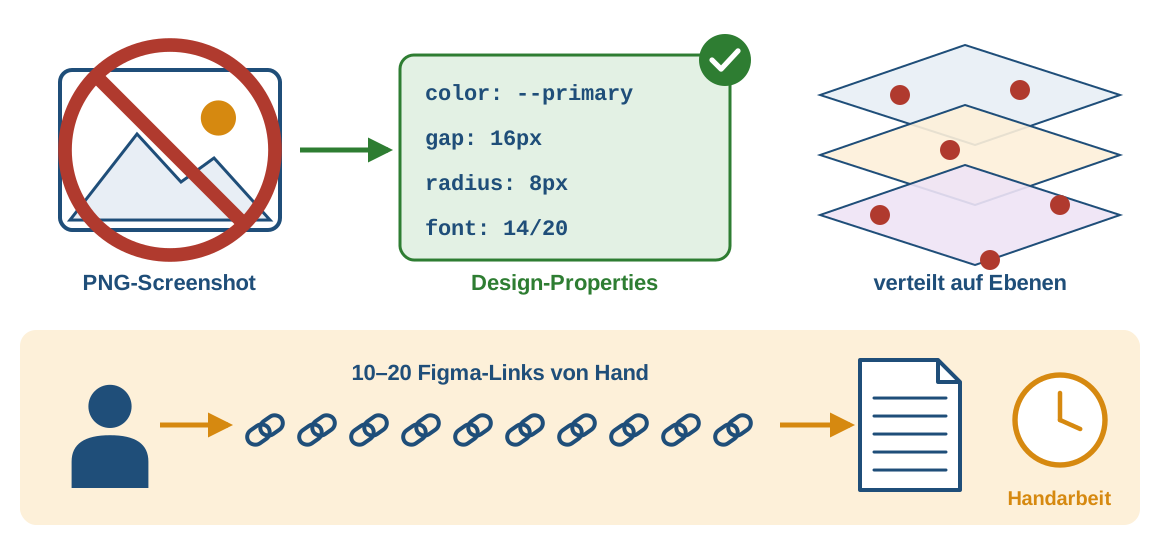
- Figma-Skill, der den Agenten anweist, auf KEINEN FALL ein Design aufgrund eines Figma-PNG-Screenshots zu machen, sondern ihn zwingt, die Figma-Design-Properties zu lesen und diese zu verwenden
- Figma-Design-Properties sind im Figma jedoch verteilt:
- verschiedene Aspekte des Designs stehen auf verschiedenen “Ebenen”
- in verschiedenen “Objekten”,
- zukünftige, aber für das aktuelle Issue noch nicht relevante Details sind auch schon drin und müssen (noch) ignoriert werden
- der Coding Agent schafft es nicht, sich aus einem einzigen Figma-Link die relevanten Punkte rauszupicken
- daher: alle relevanten Figma-Links (typischerweise 10–20) manuell zusammensuchen und ins Issue reinkopieren, genau an die Stellen im Issue, wo die zugehörigen Akzeptanzkriterien stehen.
Jedoch
- viel manuelle Recherche in Figma: Der Entwickler muss die passenden Stellen suchen, die Links erzeugen und manuell ins Issue kopieren -> viel Arbeit
- Ergebnis besser, aber nicht überzeugend: Der Coding Agent übersieht nach wie vor viele wichtige Design-Details
Iteration 3
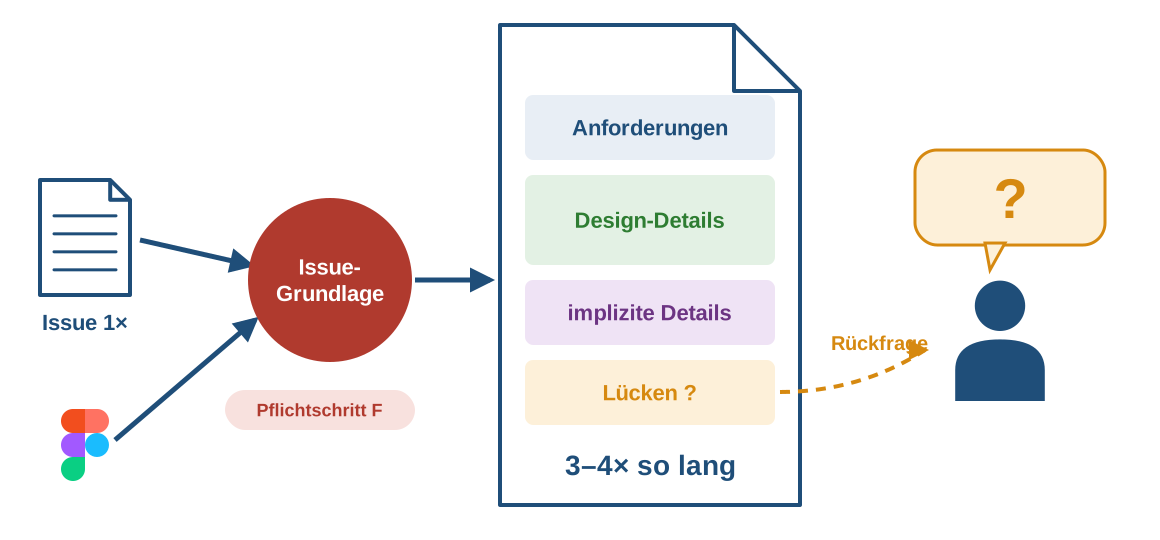
- neuer Skill “Issue-Grundlage”
- Figma-Entwürfe so anlegen, dass der Coding Agent sich selbstständig zurechtfindet
Konzept “Issue-Grundlage”:
- Issue-Inhalt zunächst ins Projekt unter tmp/issue
.md kopieren lassen. - präzise Anweisungen, wie der Agent den Figma-MCP und die Links zum Figma nutzen muss:
- siehe “Pflichtschritt F — Figma-Komponenten-Varianten” im “issue-grundlage”-Skill des Projekts
- tmp/issue
.md stark erweitern lassen um alle interessanten und auch impliziten Details, insb. bezüglich Design, aber auch alle fachlichen Definitionslücken rigoros aufdecken und per User-Rückfrage schließen. - Ergebnis ist ein neues MD-File, das 3- bis 4-mal so lang ist wie das ursprüngliche Issue in GitLab
Jedoch
- Funktioniert schon besser, aber immer noch Lücken und Missverständnisse
Iteration 4
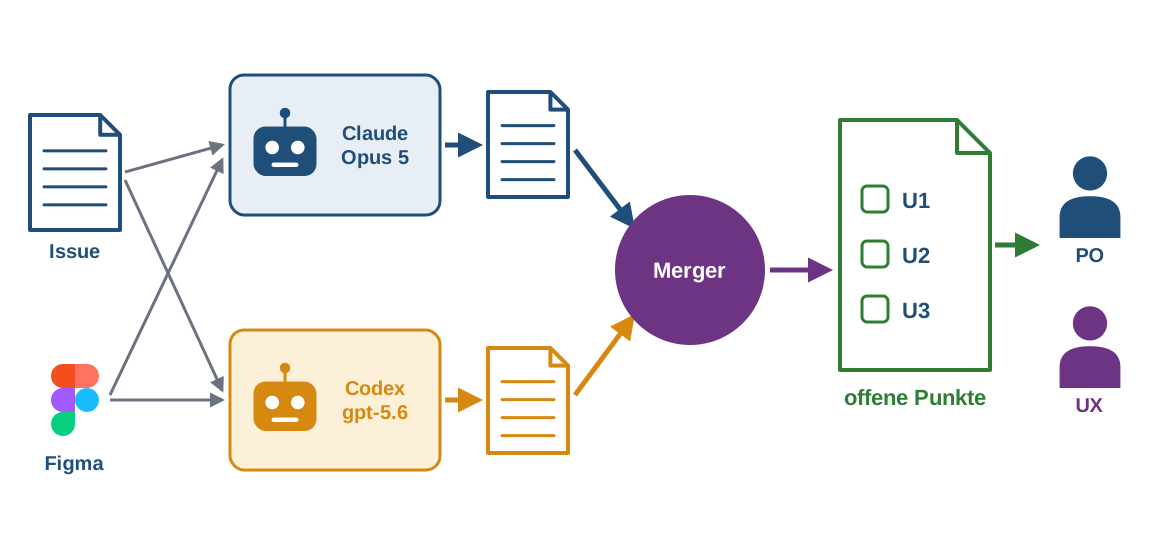
- mehrere Agenten (Claude und Codex) mit demselben Skill auf dasselbe Issue und dieselben Figma-Links ansetzen.
- 2 konkurrierende Ergebnisse produzieren
- finaler Vergleich, Deduplizierung, Aufdecken von Widersprüchen durch einen Coding Agent (hier: Claude, wegen des größeren Tokenbudgets)
- Ergebnis: eine Liste “offener Punkte”, die der Entwickler mit PO und UX-Designerin klären muss.
Der Skill
(Stand vom 27.Sept.2026)
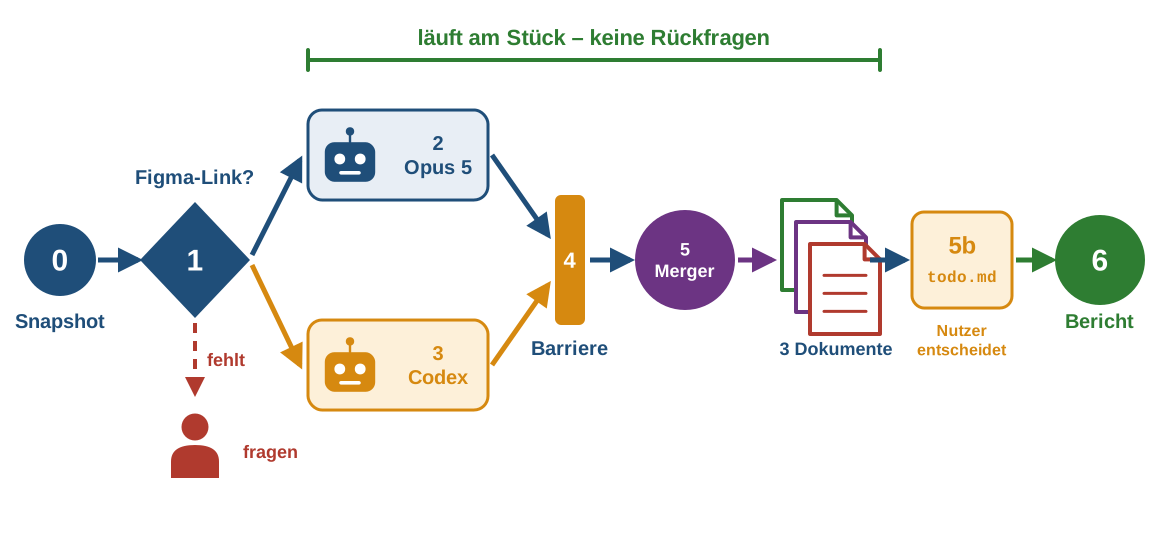
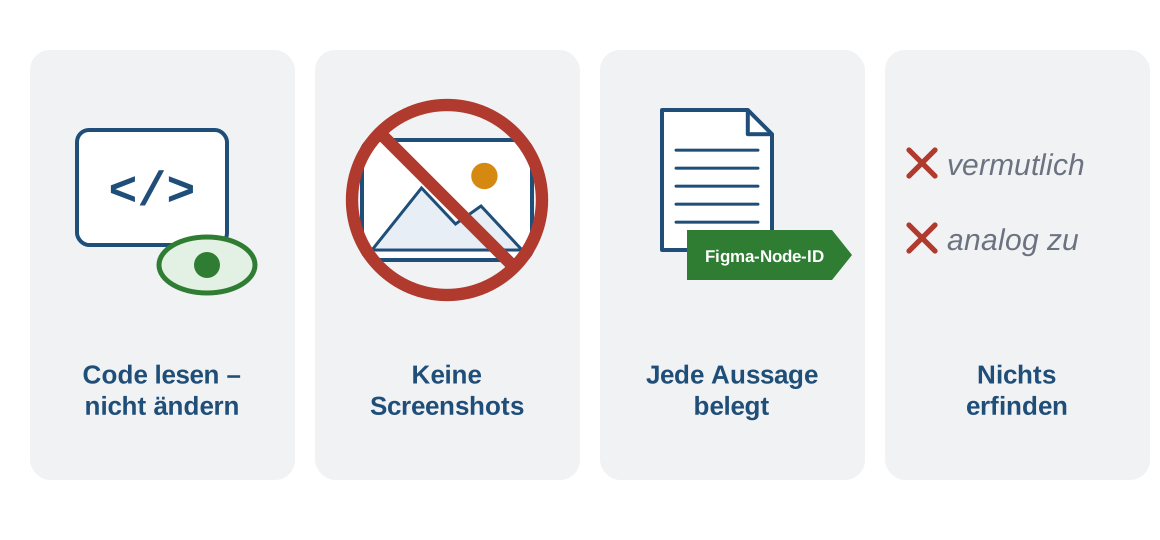
Der Skill auf einen Blick
Der Skill im Wortlaut
Description Header:
---
name: issue-grundlage
description: >-
  Erstellt vor der Planung aus einem GitLab-Work-Item und seinem Figma-Design ein
  Grundlagendokument mit Akzeptanzkriterien und Design-Specs, dazu je ein eigenes Dokument
  fuer Widersprueche und Klaerungsliste. Trigger:
  "Issue aufarbeiten", "Grundlagendokument erstellen", "Issue plus Figma". Benoetigt
  die Work-Item-Nummer; eine Figma-URL ist optional.
argument-hint: "<gitlab-work-item-nummer> [figma-url], z. B. 92"
---
Issue-Grundlage — Work Item + Figma zu einem Grundlagendokument
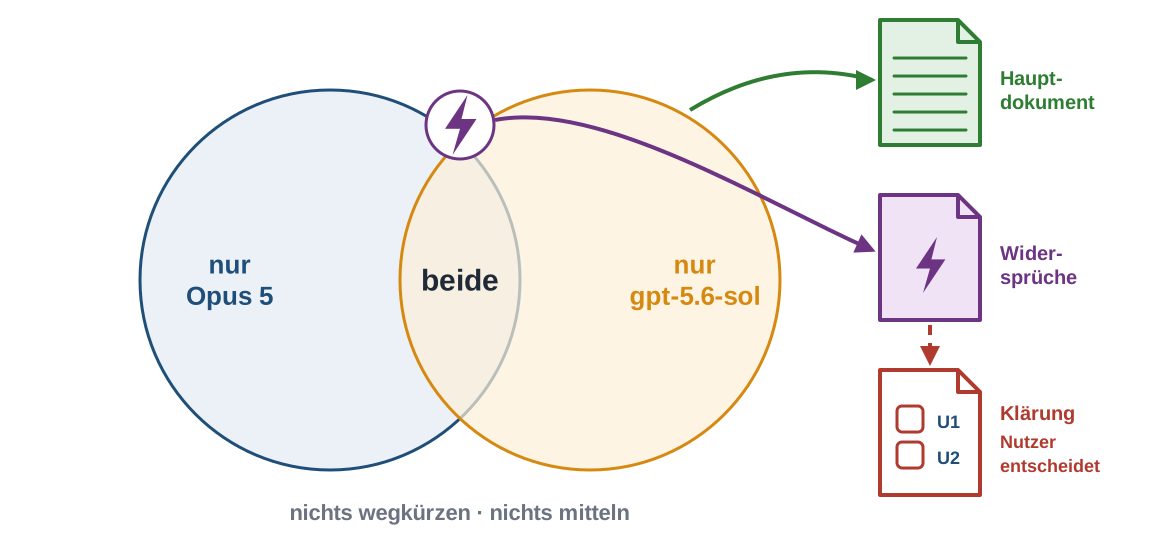
Diese Skill erzeugt die Grundlage fuer den Implementierungsplan — nicht den Plan selbst. Ergebnis sind drei verlinkte Dokumente: ein Hauptdokument, in dem jedes Akzeptanzkriterium des Work Items neben den konkreten Figma-Design-Details steht, und daneben je ein eigenes Dokument fuer die Widersprueche und fuer die Punkte, die der Nutzer klaeren muss.
Zwei unabhaengige Analysten arbeiten dasselbe Work Item aus:
| Analyst | Modell / Effort | Ergebnisdatei |
|---|---|---|
| Claude-Subagent | Opus 5 / Medium | tmp/item<N>-opus5.md |
| codex-CLI | gpt-5.6-sol / medium | tmp/item<N>-gpt5.6-sol.md |
| Zusammenfuehrung | Opus 5 / Medium | docs/item<N>-final.md (Hauptdokument) |
docs/item<N>-widersprueche.md (Abschnitt 9) |
||
docs/item<N>-klaerung.md (Abschnitt 10) |
Dazu der geteilte Issue-Snapshot tmp/issue-grundlage/issue<N>.md.
Die Zusammenfuehrung liefert drei Dokumente statt einem. Abschnitt 9 (Widersprueche) und
Abschnitt 10 (offene Punkte) stehen jeweils in einer eigenen Datei; im Hauptdokument bleiben an
ihrer Stelle die Abschnittsueberschriften mit Kurzzahlen und einem Link auf das ausgelagerte
Dokument. Grund: das Hauptdokument wird beim Lesen und Planen anders benutzt als die beiden
Arbeitslisten — die Klaerungsliste wird abgearbeitet und abgehakt, die Widerspruchsliste wird
entschieden. Die Kurzliste 0b bleibt im Hauptdokument, damit der Stand der Klaerung dort ablesbar
ist. Die Abschnittsnummern 9 und 10 bleiben erhalten, damit Verweise aus anderen Dokumenten weiter
tragen.
Nur diese drei finalen Dokumente liegen in docs/ und werden eingecheckt. Die beiden
Analysten-Zwischenergebnisse und der Snapshot liegen unter tmp/ (git-ignoriert) — sie sind
Arbeitsmaterial fuer die Zusammenfuehrung, kein Projektartefakt. Niemals ein item<N>-opus5.md
oder item<N>-gpt5.6-sol.md nach docs/ schreiben und nichts davon zu Git hinzufuegen.
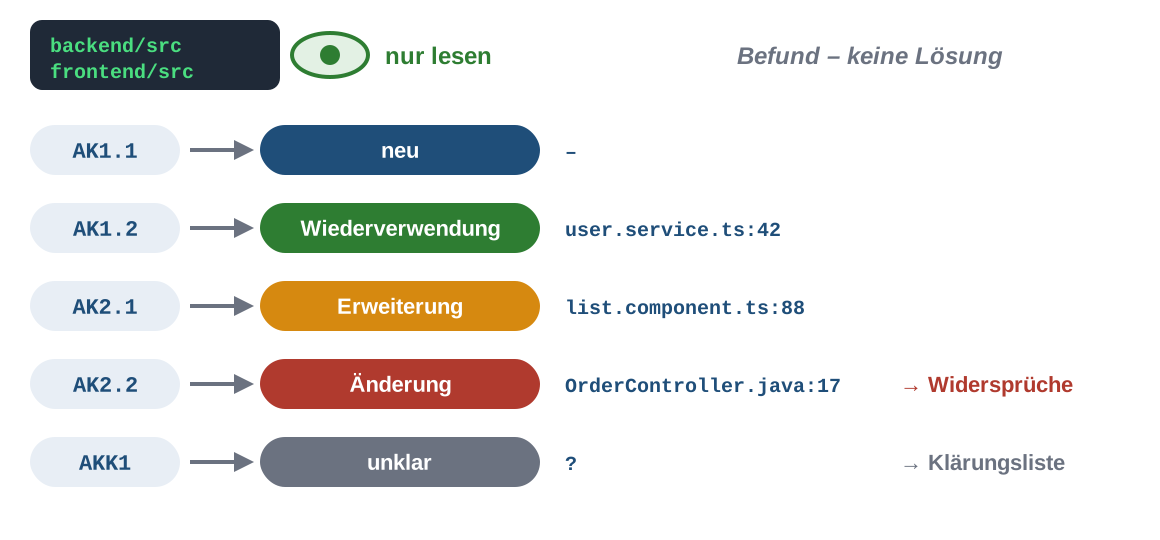
Kein Plan — aber der Bestand zaehlt. Diese Skill schreibt keinen Implementierungsplan. Sie beantwortet: Was ist gefordert, wie sieht es im Figma genau aus, was davon gibt es im Bestand schon, und was ist noch offen? Quellcode zu lesen ist dafuer ausdruecklich erlaubt und bei Erweiterungen bestehender Features Pflicht (A6b). Der Plan entsteht erst danach — aus
docs/item<N>-final.md, nachdem der Nutzer die offenen Punkte geklaert hat.
Erforderliche Eingabe
- Pflicht: die Work-Item-Nummer
<N>(z. B.92aushttps://git.office.brand-ad.de/guardops/issues/-/work_items/92). Fehlt sie, stoppen und fragen. Nicht aus dem Branch-Namen raten — ein Branch kann zu einem Task gehoeren, waehrend die Anforderung am uebergeordneten Work Item haengt. - Optional: eine Figma-URL. Nur noetig, wenn im Work Item keine steht (siehe Phase 1).
Nicht verhandelbare Regeln
- Bestandscode lesen: erlaubt, oft Pflicht — aber nur lesend. Beide Analysten duerfen
backend/src/**,frontend/src/**, Tests, Build- und Konfigurationsdateien sowiegit loglesen. Pflicht ist die Bestandsanalyse (A6b), sobald das Work Item ein bestehendes Backend-Feature erweitert oder eine bestehende UI im Frontend ausbaut: dann muss belegt werden, was wirklich neu ist, was aus dem Bestand uebernommen werden kann und was geaendert werden muss. Handelt es sich erkennbar um ein Feature auf der gruenen Wiese, wird das in 6b in einem Satz festgehalten — die Pruefung entfaellt nicht, ihr Ergebnis ist dann „kein Bestand”. Der Merger analysiert keinen Quellcode nach; er fuehrt nur die zwei Analysen zusammen. Gelesen wird ausschliesslich: keinEdit, keinWritean Quellcode, kein Build, keine Tests. - Bestand ist Befund, nicht Anforderung. Was im Code steht, aendert kein Akzeptanzkriterium. Weicht der Bestand von Issue oder Figma ab, ist das ein Widerspruch (Abschnitt 9) oder ein offener Punkt (Abschnitt 10) — es wird nicht stillschweigend als „so ist es halt” uebernommen.
- Screenshots sind keine Designquelle. Bilder, die am Issue haengen, dienen hoechstens der Orientierung. Verbindliche Design-Werte kommen ausschliesslich aus dem Figma-MCP. Ein Screenshot ersetzt niemals den Figma-Link.
- Nichts erfinden. Jede Aussage im Dokument ist entweder mit einer Issue-Stelle oder mit einer
Figma-Node-ID belegt. Alles andere gehoert in die Klaerungsliste (Abschnitt 10; final
ausgelagert nach
docs/item<N>-klaerung.md) — nicht in die Spezifikation. Kein „vermutlich”, kein „analog zu”, kein stilles Auffuellen von Luecken. - Anti-Pattern-Regel (Figma-Luecken): Eine „Luecke im Figma” darf erst behauptet werden, wenn der Komponenten-Set-Lookup (Pflichtschritt F, Schritte 1–4) durchgefuehrt wurde und nichts ergeben hat. Eine notierte Vermutung ohne durchgefuehrten Lookup ist ein Fehler, kein Finding.
- Nur die fuenf Ergebnisdateien schreiben (plus der Snapshot in Phase 0). Keine Aenderung an
bestehenden Dokumenten, kein
git add, kein Commit. Ausnahme: der TODO-Abgleich aus Phase 5b haengt Abschnitt 13 andocs/item<N>-final.mdan. - TODO-Abgleich ist Pflicht. Jeder Lauf prueft alle
todo.mdunterdocs/,backend/docs/undfrontend/docs/gegen das Work Item (Phase 5b). Passende TODOs werden nie still uebernommen und nie still verworfen — der Nutzer entscheidet je Eintrag. Den Abgleich machen der Orchestrator und nicht die Analysten: deren Katalog bleibt unveraendert, damit die zwei Analysen vergleichbar bleiben, undtodo.mdist keine Quelle fuer Akzeptanzkriterien. - Modell und Effort der Analysten sind fest verdrahtet und unabhaengig vom Modell, mit dem diese Skill aufgerufen wurde.
Pflichtschritt F — Figma-Komponenten-Varianten
Dieser Abschnitt ist der Kern der Skill. Beide Analysten arbeiten ihn vollstaendig ab.
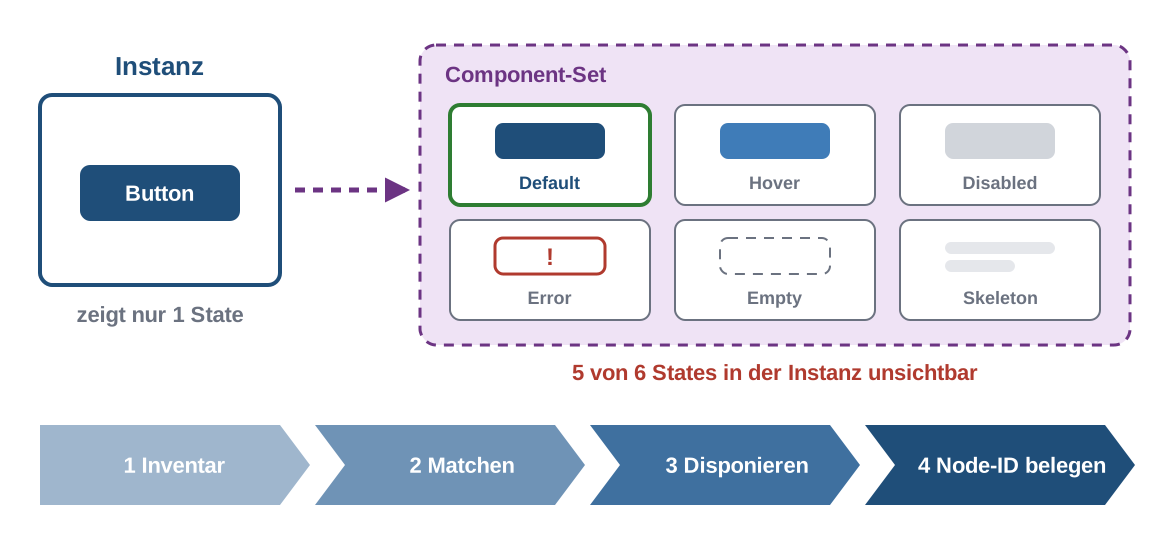
get_metadata / get_design_context auf einer Komponenten-INSTANZ zeigen nur den aktuell
eingestellten Variant-State. Andere States (Emptystate, Skeleton, Hover, Disabled, Error, …) sind
darin unsichtbar — sie existieren nur am Component-Set (in der Figma-UI: „Komponenten-
verhalten untersuchen”). Ohne diesen Schritt sieht eine Analyse vollstaendig aus, obwohl States
fehlen: jede Instanz ist grundsaetzlich verdaechtig.
Darum MUSS bei jeder Figma-Analyse:
- Einmal pro Datei ein vollstaendiges Komponenten-Inventar erheben:
get_metadataauf der „Components”-Page der aktiven Datei — in beiden Harnesses. Der Weg erfasst auch lokale, unveroeffentlichte Sets samt Variant-Properties, Optionen und Node-IDs.list_file_components_for_code_connect(fileKey)gibt es nur im gehosteten Connector, der hier nicht verwendet wird. Den Erhebungsweg in Abschnitt 11 nennen. Ist die Components-Page nicht erreichbar, die Analyse als unvollstaendig markieren; der Schritt darf nie stillschweigend entfallen. - Jede in den analysierten Frames vorkommende Instanz (erkennbar an
data-name/ Layer-Name) gegen dieses Inventar matchen. -
Fuer jede Komponente ALLE Variant-Properties disponieren — Ergebnis als Pflicht- Tabelle (Abschnitt 4.2 der Berichtsstruktur):
Komponente | Node-ID Set | Variant-Properties (alle Optionen) | DispositionDisposition ist entweder „referenziert: Node-ID …” oder „nicht relevant, weil …”. Eine verwendete Komponente ohne Zeile bedeutet: die Analyse ist unvollstaendig.
- Relevante Varianten aufloesen:
get_metadataauf die Set-Node → Node-ID desState=…-Symbols →get_screenshotbzw.get_design_contextpro Variante → Node-ID ins Ergebnisdokument.
Figma-Zugang je Harness — zwei verschiedene Mechanismen
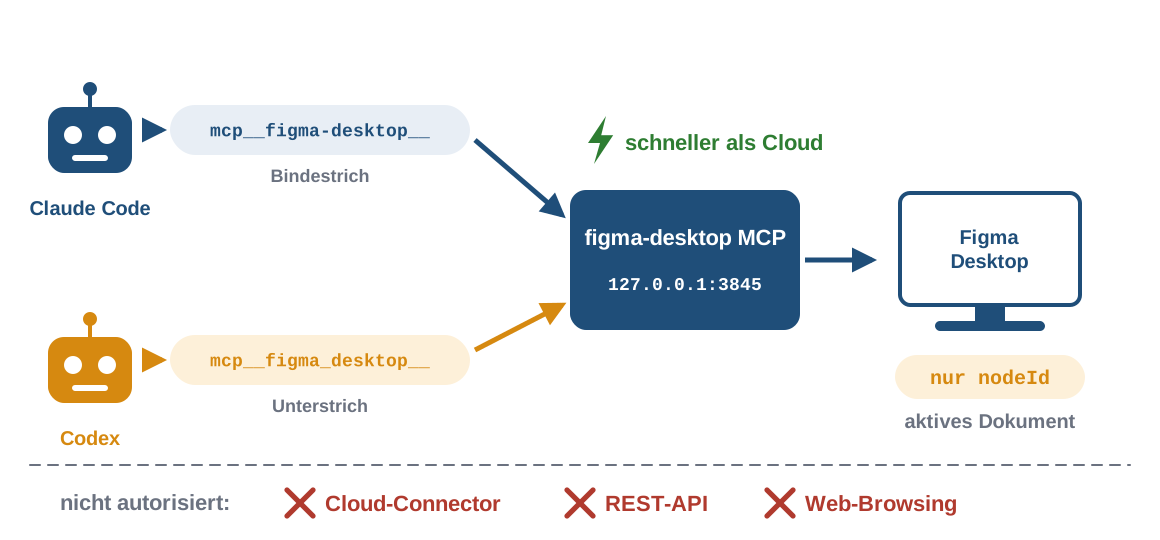
Beide Harnesses nutzen denselben lokalen Dev-Mode-Server (http://127.0.0.1:3845/mcp), nur
der Namensraum unterscheidet sich. Der gehostete Connector — mcp__plugin_figma_figma__* in
Claude Code, mcp__codex_apps__figma_* in Codex — ist hier nicht autorisiert und wird nicht
verwendet, auch nicht als Fallback.
| Harness | Namespace |
|---|---|
| Claude Code | mcp__figma-desktop__<name> (Bindestrich) |
| Codex | mcp__figma_desktop__<name> (Unterstrich) |
Zuerst .agents/skills/figma-desktop/SKILL.md vollstaendig lesen — in Claude Code auch per
Skill-Tool figma-desktop ladbar. Sie besitzt Namensraeume, Parameter und Fehlerbehandlung.
Die Tools koennen deferred sein und im anfaenglichen Tool-Listing fehlen; vor einer
Nichtverfuegbarkeitsmeldung im Runtime-Tool-Katalog gezielt nach dem Praefix des eigenen Harness
suchen (Claude Code: ToolSearch mit
select:mcp__figma-desktop__get_metadata,mcp__figma-desktop__get_design_context,mcp__figma-desktop__get_screenshot,mcp__figma-desktop__get_variable_defs).
Bei Unklarheit an den Tool-Namen im Tool-Listing des laufenden Harness orientieren, nicht raten.
Vor jedem get_design_context ausserdem den verpflichtenden Skill figma:figma-design-to-code
laden, dabei aber den lokalen Namespace beibehalten.
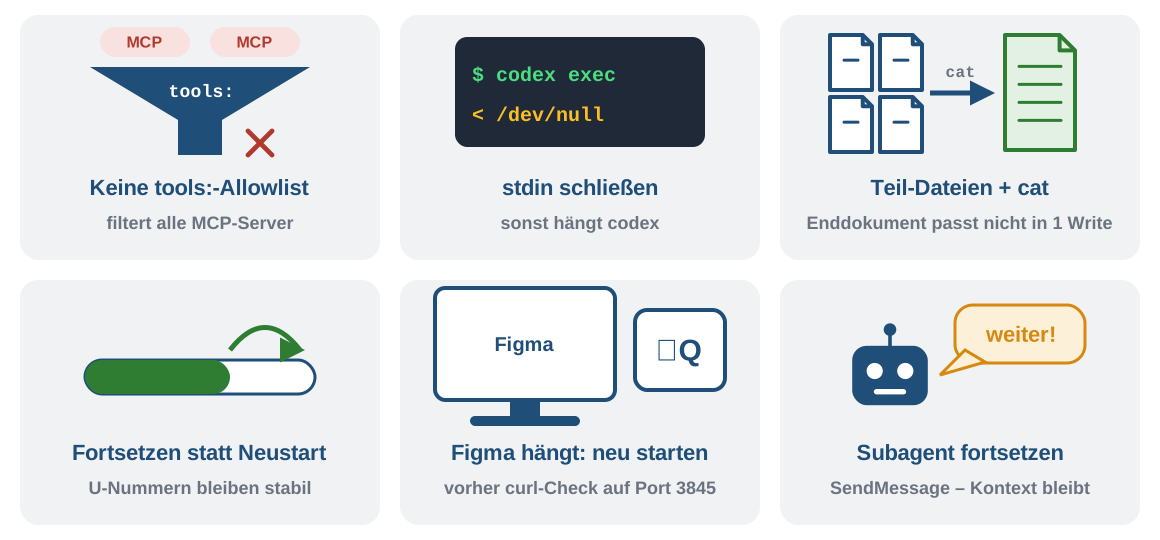
Antwortet der lokale Server nicht mehr — Timeout, haengender Aufruf oder Connection-Fehler bei
jedem Tool —, mit
curl -sS -m 5 -o /dev/null -w '%{http_code}\n' http://127.0.0.1:3845/mcp gegenpruefen und den
Nutzer bitten, Figma Desktop vollstaendig zu beenden (⌘Q) und neu zu starten; danach erneut
aufrufen. Das ist ein anderer Fehlerfall als die tools:-Allowlist weiter unten und laesst sich
nicht durch einen Subagenten-Neustart beheben.
Der lokale Server arbeitet mit dem in Figma Desktop aktiven Dokument. Seine Tools akzeptieren
nodeId und je nach Tool clientFrameworks / clientLanguages, aber kein fileKey. Nicht auf
mcp__codex_apps__figma_*, Web-Browsing oder die Figma-REST-API ausweichen. Ist das falsche Figma-
Dokument aktiv, den Nutzer bitten, die verlinkte Datei in Figma Desktop zu aktivieren, und danach
erneut aufrufen.
fileKey ist der Pfadbestandteil der URL und bleibt als Quellenbeleg im Ergebnisdokument:
https://www.figma.com/design/<fileKey>/<Name>?node-id=<a>-<b> → in Tool-Aufrufen wird node-id
als <a>:<b> geschrieben. Claude-/Cloud-Tools erhalten fileKey, wenn ihr Schema ihn verlangt;
Codex sendet beim lokalen figma-desktop nur nodeId und die vom konkreten Tool unterstuetzten
weiteren Parameter.
Analysekatalog (beide Analysten, identisch)
Beide arbeiten genau diesen Katalog ab — nur so sind die zwei Ergebnisse vergleichbar.
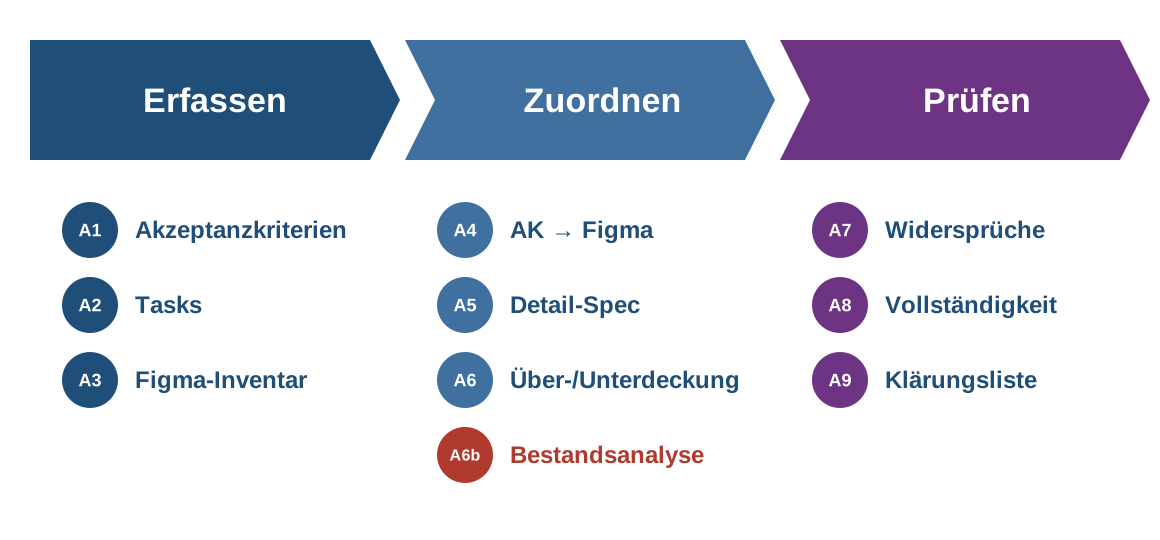
A1 — Anforderungen und Akzeptanzkriterien vollstaendig erfassen
Quelle ist ausschliesslich der Snapshot tmp/issue-grundlage/issue<N>.md: Beschreibung, alle
Tasks und alle Kommentare, nicht jedoch die ganze “DoD”-Liste (Definition of Done), sondern nur diese 4 Punkte:
- DEV: Barrierefreiheit berücksichtigt und
- DEV: Tests bei neuen Seiten und Zuständen mit ‘testA11y()’ hinzugefügt
- DEV: Projektsetup muss dokumentiert und auf dem aktuellen Stand sein
- DEV: Technische Doku wurde angepasst
AK-IDs sind verbindlich und stabil zu bilden (die Zusammenfuehrung haengt daran):
- Die Nummerierung des Issues uebernehmen. Aus dem Abschnitt „2. Berechnung” wird
AK2, sein erster AufzaehlungspunktAK2.1, der zweiteAK2.2— in Dokumentreihenfolge, ohne Umsortierung, ohne Zusammenfassen zweier Punkte zu einem. - Anforderungen, die nur in einem Kommentar stehen, als
AKK1,AKK2, … fuehren, jeweils mit Autor und Datum des Kommentars. - Anforderungen aus einem Task als
T<task-iid>.1,T<task-iid>.2, … fuehren. - Jede AK-Zeile bekommt den Wortlaut aus dem Issue (gekuerzt nur, wo eindeutig), nicht eine Paraphrase.
A2 — Tasks
Jeder Task des Work Items bekommt eine Zeile: iid | Titel | Typ | Bereich (BE/FE) | eigene
Anforderungen? | Bezug zu AK. Tasks ohne eigene Beschreibung ausdruecklich als „nur Titel, keine
zusaetzliche Anforderung” markieren — nicht weglassen, damit sichtbar bleibt, dass sie geprueft
wurden.
A3 — Figma-Inventar
- Alle Figma-Links aus Beschreibung, Tasks und Kommentaren aufloesen; je Link
get_metadataauf die Node, dannget_design_contextfuer die relevanten Frames. - Kindbaum jedes Frames durchgehen: Frame-Namen, Reihenfolge, sichtbare Texte (deutsch!), Zahlenformate, Icons, Zustaende.
- Design-Specs mitnehmen: Typografie, Farben/Token-Namen (
get_variable_defs), Abstaende, Geometrie, Radien, Breakpoints — als Werte mit Token-Namen, nicht nur „grau”. - Nodes, die als Design-Annotation/Spec-Sheet erkennbar sind (Style-Annotations, Spec-Frames), als solche kennzeichnen: sie sind Referenz fuer Werte, aber kein umzusetzender Screen.
- Pflichtschritt F vollstaendig ausfuehren.
A4 — Zuordnung AK ↔ Figma (Kern des Dokuments)
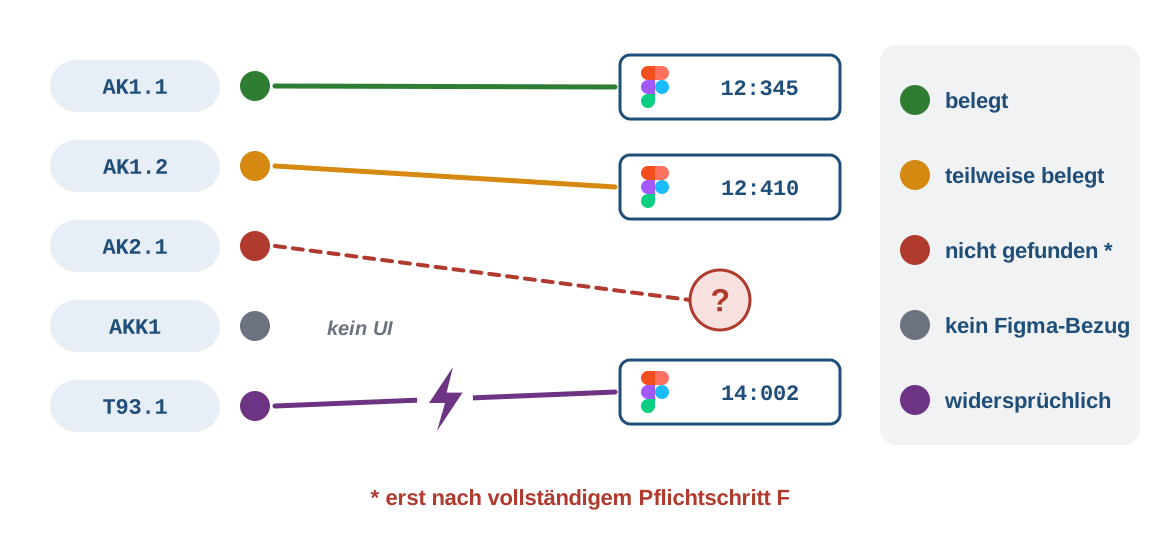
Jede AK-Zeile aus A1 bekommt genau eine Zeile in der Zuordnungstabelle mit:
AK-ID | Kurztext | Figma-Node-ID(s) | konkrete Design-Details (Texte, Werte, Zustaende) | Status.
Status ist einer von:
| Status | Bedeutung |
|---|---|
belegt |
Figma zeigt das Kriterium eindeutig; Node-ID genannt. |
teilweise belegt |
Figma zeigt einen Teil; der fehlende Teil ist in Abschnitt 10 als offener Punkt gefuehrt. |
kein Figma-Bezug |
Rein fachliches/Backend-Kriterium ohne UI-Anteil — mit Begruendung. |
im Figma nicht gefunden |
Nur zulaessig nach vollstaendigem Pflichtschritt F, mit Angabe, was gesucht wurde. |
widerspruechlich |
Issue und Figma sagen Unterschiedliches → Abschnitt 9. |
A5 — Detailspezifikation je AK
Fuer jedes AK mit UI-Anteil so ausformulieren, dass ein Entwickler es ohne Rueckfrage umsetzen koennte: exakte deutsche Beschriftungen und Texte, Zahlen-/Datumsformate, Sortierung und Standardwerte, Grenzwerte und Validierung, Fehler-, Lade- und Leerzustaende, Interaktionen und Zustandsuebergaenge, Barrierefreiheit (Label, Fokus, Rollen). Jeder Wert mit Herkunft: Issue-Stelle oder Figma-Node-ID. Was sich nicht belegen laesst, wandert nach Abschnitt 10 — nicht raten.
A6 — Ueberdeckung und Unterdeckung
- Im Figma vorhanden, im Issue nicht gefordert → Abschnitt 7 (Scope-Kandidat; der Nutzer entscheidet, ob das in den Scope gehoert).
- Im Issue gefordert, im Figma nicht auffindbar → Abschnitt 8, mit dem Nachweis, dass Pflichtschritt F durchgefuehrt wurde.
A6b — Bestandsanalyse (Neu / Wiederverwendung / Aenderung)
Pflicht, sobald das Work Item Bestehendes erweitert — ein Backend-Feature, das es schon gibt, oder eine UI, die schon existiert. Ziel ist die Trennung: Was ist wirklich neu, was traegt der Bestand schon, und was muss angefasst werden?
Vorgehen:
- Einstiegspunkte suchen (
Grep/Glob) — Endpunkt-Pfade, Domain-Begriffe, Komponenten- und Routen-Namen aus den AK. Backend: Controller/Adapter, Service, Domain-Typ, Repository, Modulith-Modul. Frontend: Route, Container-/Praesentations-Komponente, Signal-Store/Service, Model-Typ, verwendete spartan-ng-Bausteine. - Die gefundenen Stellen tatsaechlich lesen — Signaturen, DTO-/Model-Felder, vorhandene Zustaende (Lade-, Fehler-, Leerzustand), bestehende Tests.
- Je AK aus A1 eine Zeile bilden mit einer dieser Einstufungen:
| Einstufung | Bedeutung |
|---|---|
neu |
Im Bestand gibt es dafuer nichts; wird komplett neu gebaut. |
Wiederverwendung |
Bestehender Code deckt es ab und wird unveraendert genutzt — mit Pfad belegt. |
Erweiterung |
Bestehender Code traegt, muss aber ergaenzt werden (neues Feld, neue Variante, neuer Zweig). |
Aenderung |
Bestehendes Verhalten widerspricht der Anforderung und muss umgebaut werden → zusaetzlich Abschnitt 9. |
unklar |
Ohne Entscheidung des Nutzers nicht zuzuordnen → zusaetzlich Abschnitt 10. |
- Jede Zeile mit Pfad und Zeilennummer belegen (
frontend/src/app/...ts:42). Eine Einstufung ohne Beleg ist eine Vermutung und gehoert nach Abschnitt 10, nicht in die Tabelle. - Keine Loesung entwerfen. Kein Klassenschnitt, keine Arbeitspakete, keine Reihenfolge — das ist Sache der Planung. Hier steht nur der Befund.
Ist das Work Item erkennbar ein Neubau ohne Bestandsbezug, bleibt die Tabelle leer und 6b enthaelt einen Satz mit der Begruendung und den Suchbegriffen, die nichts ergeben haben.
A7 — Widersprueche
Drei Arten, jeweils mit Belegen auf beiden Seiten:
- Issue gegen Figma — z. B. Text, Reihenfolge, Anzahl oder Schwellwert weicht ab.
- Issue gegen Issue — Beschreibung gegen Kommentar, oder Kommentar gegen Kommentar. Grundregel: der juengere Kommentar hat Vorrang — das ist eine Annahme und muss als offener Punkt gefuehrt werden, wenn daran eine Umsetzungsentscheidung haengt.
- Figma gegen Figma — zwei Frames oder eine Variante gegen ihr Spec-Sheet widersprechen sich; auch Widersprueche zum dokumentierten spartan-ng-Standard hier melden (mit Node-ID), statt sie ungeprueft zu uebernehmen.
A8 — Vollstaendigkeits- und Widerspruchsfreiheitspruefung
Am Ende ausdruecklich pruefen und im Dokument bestaetigen:
- Jedes AK aus A1 hat eine Zeile in A4. (Anzahl abgleichen und beide Zahlen nennen.)
- Jede verwendete Komponente hat eine Zeile in der Varianten-Tabelle (Pflichtschritt F.3).
- Jeder Figma-Link aus dem Issue ist aufgeloest oder mit Begruendung verworfen.
- Kein Status
im Figma nicht gefundenohne durchgefuehrten Pflichtschritt F. - Jedes AK aus A1 hat eine Zeile in 6b, oder 6b begruendet, warum es keinen Bestandsbezug gibt.
Jede Einstufung ausser
neuist mit Pfad und Zeile belegt.
A9 — Klaerungsliste
Alle offenen Punkte als U1, U2, … Jeder Eintrag: Frage (eine Zeile, entscheidbar), Bezug
(AK-ID / Node-ID / Issue-Stelle), warum es blockiert (was ohne Antwort falsch werden kann),
Optionen und — wo moeglich — eine Empfehlung mit Begruendung. Keine rhetorischen Fragen und
keine Punkte, die sich aus Issue oder Figma bereits beantworten lassen.
Verbindliche Berichtsstruktur (beide Analysten, exakt)
Die Zusammenfuehrung in Phase 4 haengt an dieser Gliederung — nicht abweichen.
Jeder Analyst schreibt eine Datei mit allen Abschnitten 0–11 (inkl. 6b), Abschnitt 9 und 10 eingeschlossen. Die Auslagerung in eigene Dokumente betrifft nur das Enddokument aus Phase 5.
# Grundlagendokument Work Item <N> — „<Titel>" — Analyst: <Modell/Effort>

## 0. Kopf
- Work Item: <URL> — „<Titel>", Typ, Labels, State
- Tasks: <iids> (<Anzahl>)
- Kommentare beruecksichtigt: <Anzahl> (nicht-System)
- Quellen-Snapshot: tmp/issue-grundlage/issue<N>.md
- Figma-Datei: <fileKey> — „<Dateiname>"
- Analysierte Figma-Nodes: <node-id> (<Kurzname>), …
- Datum: <YYYY-MM-DD>

## 1. User Story und Ziel
## 2. Anforderungen und Akzeptanzkriterien (A1)
| AK-ID | Wortlaut (Issue) | Quelle (Beschreibung/Kommentar/Task) | Bereich (BE/FE/beide) |

## 3. Tasks (A2)
| iid | Titel | Typ | Bereich | eigene Anforderungen | Bezug zu AK |

## 4. Figma-Inventar (A3)
### 4.1 Analysierte Frames
| Node-ID | Frame-Name | Zweck | Screen / Spec-Sheet |
### 4.2 Komponenten-Varianten-Disposition (PFLICHT — Pflichtschritt F.3)
| Komponente | Node-ID Set | Variant-Properties (alle Optionen) | Disposition |
### 4.3 Design-Specs (Typografie, Farben/Token, Abstaende, Geometrie)

## 5. Zuordnung AK ↔ Figma (A4)
| AK-ID | Kurztext | Figma-Node-ID(s) | Design-Details | Status |

## 6. Detailspezifikation je AK (A5)
### AK<x> — <Titel>
- **Anforderung (Issue):** …
- **Figma-Beleg:** <node-id> — …
- **Konkrete Vorgaben:** Texte, Formate, Zustaende, Grenzwerte, Interaktion, A11y
- **Offen:** <U-IDs oder „keine">

## 6b. Bestandsanalyse — Neu, Wiederverwendung, Aenderung (A6b)
| AK-ID | Bestand (Pfad:Zeile) | Einstufung | Was konkret traegt / fehlt / muss geaendert werden |

## 7. Im Figma vorhanden, im Issue nicht gefordert (A6)
## 8. Im Issue gefordert, im Figma nicht auffindbar (A6 — nur nach Pflichtschritt F)
## 9. Widersprueche (A7)
| # | Art | Seite A (Beleg) | Seite B (Beleg) | Auswirkung |

## 10. Offene Punkte — Klaerung durch den Nutzer (A9)
### U1 — <Frage>
- **Bezug:** …
- **Warum blockierend:** …
- **Optionen:** …
- **Empfehlung:** …

## 11. Vollstaendigkeitspruefung, nicht geprueft und Annahmen (A8)
- AK gesamt: <n> — Zeilen in Abschnitt 5: <n>
- Komponenten mit Instanz im Frame: <n> — Zeilen in 4.2: <n>
- Figma-Links im Issue: <n> — aufgeloest: <n>
- Nicht geprueft / nicht verfuegbar: …
- Annahmen: …
Ablauf
Phase 0 — Vorbereitung und Snapshot
<N>aus dem Argument uebernehmen; fehlt es, stoppen und fragen.-
Verzeichnisse anlegen und alte Ergebnisdateien dieses
<N>bereinigen (die fuenf Dateien aus der Tabelle oben), damit nichts aus einem frueheren Lauf kollidiert. Dem Nutzer kurz nennen, was bereinigt wurde. Dateien anderer Nummern bleiben unangetastet.mkdir -p tmp/issue-grundlage docs -
Work Item, Tasks und Kommentare holen. Alle
glab-Aufrufe mitGLAB_HOST=git.office.brand-ad.deund — auf macOS —dangerouslyDisableSandbox: true; die Aufrufe brauchen Netz und laufen teils >60 s, darum grosszuegigestimeoutsetzen.export GLAB_HOST=git.office.brand-ad.de glab api "projects/guardops%2Fissues/issues/<N>" > tmp/issue-grundlage/issue<N>.json glab api "projects/guardops%2Fissues/issues/<N>/notes?per_page=100" > tmp/issue-grundlage/issue<N>-notes.jsonTasks (Child-Work-Items) gibt es in der REST-API nicht — sie haengen als Hierarchie-Widget am Work Item und werden per GraphQL geholt:
glab api graphql -f query='query { namespace(fullPath: "guardops/issues") {
  workItems(iid: "<N>") { nodes { iid title workItemType { name } widgets {
    ... on WorkItemWidgetHierarchy {
      parent { iid title }
      children { nodes { iid title workItemType { name } } } } } } } }' \
  > tmp/issue-grundlage/issue<N>-tasks.json
Die Child-
iids sind normale Issue-iids — Beschreibung und Kommentare je Task damit ueber dieselben REST-Endpunkte holen:for T in <task-iids>; do glab api "projects/guardops%2Fissues/issues/$T" > tmp/issue-grundlage/task$T.json glab api "projects/guardops%2Fissues/issues/$T/notes?per_page=100" > tmp/issue-grundlage/task$T-notes.json doneHat das Work Item ein
parent, dessen Beschreibung ebenfalls lesen und im Snapshot als Kontext kennzeichnen (nicht als eigene AK-Quelle). -
Snapshot
tmp/issue-grundlage/issue<N>.mdschreiben. Beide Analysten lesen denselben Snapshot, damit sie garantiert gegen identische Anforderungen arbeiten (und codex nicht auf eigene Netzwerkzugriffe angewiesen ist). Inhalt:- Titel,
iid, Typ,state, Labels,web_url, - die vollstaendige, ungekuerzte Beschreibung,
- je Task:
iid, Titel, Typ und die vollstaendige Beschreibung (oder „keine Beschreibung”), - alle nicht-System-Kommentare (
.system == false) des Work Items und der Tasks in chronologischer Reihenfolge, mit Autor und Datum — Kommentare enthalten regelmaessig spaetere Entscheidungen, die den Beschreibungstext ueberschreiben, -
eine Liste aller Figma-Links aus Beschreibung, Tasks und Kommentaren:
grep -ohE 'https://www\.figma\.com/design/[^ )"]*' tmp/issue-grundlage/issue<N>.md | sort -u
Nichts zusammenfassen, nichts weglassen — der Snapshot ist die Sollquelle.
- Titel,
Phase 1 — Figma-Link sicherstellen (ggf. Rueckfrage)
Aus dem Snapshot die Figma-Links ziehen und fileKey + node-ids isolieren. Jedes Issue sollte
mindestens einen echten Figma-Link haben. Die vollstaendigen URLs ebenfalls aufbewahren — der
codex-Prompt in Phase 3 braucht sie, um die aktive Desktop-Datei und die Node-IDs eindeutig zu
pruefen.
- Link gefunden: weiter mit Phase 2. Mehrere Links: alle an beide Analysten uebergeben.
- Kein Link, aber die Skill wurde mit Figma-URL-Argument aufgerufen: diese verwenden.
- Kein Link und kein Argument: stoppen und den Nutzer nach der Figma-URL fragen. Dabei
ausdruecklich sagen, dass am Issue haengende Screenshots keine gueltige Designquelle sind und
eine
figma.com/design/...?node-id=…-URL gebraucht wird. Nicht mit einem geratenen Link weiterarbeiten und nicht ohne Figma starten.
Vorab-Check des lokalen Figma-Servers — bevor Analysten starten, denn beide haengen an ihm:
curl -sS -m 5 -o /dev/null -w '%{http_code}\n' http://127.0.0.1:3845/mcp— kein HTTP-Status heisst: Server haengt oder Figma Desktop laeuft nicht.- In Claude Code die Tools per
ToolSearch(select:mcp__figma-desktop__get_metadata,…, siehe oben) laden und einmalget_metadataauf eine Node-ID aus dem Issue aufrufen. Das belegt zugleich, dass die verlinkte Datei aktiv ist. FindetToolSearchnichts, istfigma-desktopin Claude Code nicht registriert:claude mcp get figma-desktoppruefen (erwartet: Projekt-Scope aus.mcp.json, Status verbunden); steht er auf „Pending approval”, muss der Nutzer ihn in einer interaktiven Sitzung freigeben.
Schlaegt einer der Schritte fehl, den Nutzer mit dem Text aus der Skill figma-desktop bitten,
Figma Desktop vollstaendig zu beenden (⌘Q), neu zu starten und die verlinkte Datei zu oeffnen;
danach beide Schritte wiederholen. Nicht ohne funktionierenden lokalen Server in Phase 2/3
starten.
Danach kurz ausgeben: <N>, Titel, Anzahl Tasks, Anzahl Kommentare, fileKey und die gefundenen
Node-IDs. Ab hier laufen die Phasen 2–5 am Stueck durch; ausser den Abbruchfaellen in Phase 0/1
und einem haengenden Figma-Server (Phase 2) gibt es keine Rueckfrage mehr.
Phase 2 — Analyst 1: Claude-Subagent (Opus 5 / Medium)
Einen Subagenten mit subagent_type: "issue-grundlage-opus5" starten (Definition:
.claude/agents/issue-grundlage-opus5.md, Modell/Effort dort fest verdrahtet). Kein inline
model-Argument — das kann nur grobe Aliase und keinen Effort.
Die Definition hat absichtlich keine
tools:-Allowlist. Eine Allowlist filtert die MCP-Server heraus — der Subagent kaeme dann nicht an die Figma-Tools und wuerde Pflichtschritt F ueber einen Ersatzweg erledigen. Nicht „aufraeumen”.
Der Prompt uebergibt: <N> und die Work-Item-URL, den Snapshot-Pfad, fileKey und alle
Figma-Node-IDs mit ihrer Herkunft, den Zielpfad tmp/item<N>-opus5.md und den Hinweis, dass
Analysekatalog, Pflichtschritt F und Berichtsstruktur vollstaendig in
.agents/skills/issue-grundlage/SKILL.md stehen und exakt zu befolgen sind.
Wenn der lokale Server waehrend der Analyse haengt
Der Server bleibt gelegentlich mitten im Lauf stehen. Beginnt die Abschlussmeldung des Subagenten
mit FIGMA-MCP HAENGT, den Nutzer um den Neustart von Figma Desktop bitten (Text aus der Skill
figma-desktop), nach seiner Bestaetigung den curl-Check wiederholen und denselben
Subagenten per SendMessage fortsetzen („Figma Desktop ist neu gestartet, mach beim
fehlgeschlagenen Aufruf weiter”) — er behaelt dabei seinen bisherigen Kontext. Nicht auf den
Rueckfallweg unten ausweichen: der ist fuer fehlendes MCP im Subagenten, nicht fuer einen
haengenden Server. Laeuft codex parallel, ist er vom selben Haenger betroffen; seine Logdatei
pruefen und ihn gegebenenfalls nach dem Neustart erneut starten.
Wenn der Subagent kein MCP hat: Ursache pruefen, nicht ausweichen
Antwortet der lokale Server gar nicht mehr auf Port 3845 (siehe oben), hilft keine der folgenden Massnahmen — dann muss der Nutzer Figma Desktop neu starten. Erst danach weiterlesen.
Findet ToolSearch im Subagenten keine mcp__figma-desktop__*-Tools, zuerst pruefen, ob der
Server in Claude Code registriert ist (claude mcp get figma-desktop; Eintrag in .mcp.json).
Ohne Registrierung sieht kein Subagent den lokalen Server, egal was diese Skill vorschreibt.
Meldet der Subagent, die Figma-MCP-Tools seien nicht aufrufbar, ist die haeufigste Ursache eine
tools:-Allowlist in seiner Agent-Definition — die filtert alle MCP-Server heraus, und
ToolSearch findet dann ueberhaupt keine deferred Tools. Belegt am 2026-08-11: mit Allowlist
schlug jeder Figma-Aufruf fehl, nach dem Entfernen der Zeile luden dieselben Tools im selben
Agent-Typ sofort — ohne Neustart von Claude Code. Zwei Fallen dabei:
- Die Meldung „
ListMcpResourcesToolis disabled for this session, in subagents as well as here” betrifft nur dieses eine Tool. Sie ist kein Beleg, dass MCP session-weit aus ist — ein Gegentest mit einemgeneral-purpose-Subagenten (der keine Allowlist hat) entscheidet das in wenigen Sekunden und ist vor jeder anderen Erklaerung faellig. - Eine Aenderung an der Agent-Definition greift erst fuer danach gestartete Subagenten. Einen Lauf, der Sekunden nach der Aenderung startet, kann noch die alte Definition treffen.
Weicht der Subagent stattdessen auf Sekundaerquellen (aeltere tmp/-Artefakte) oder die
Figma-REST-API aus, entsteht eine Analyse, die belegt aussieht, aber Pflichtschritt F nicht
ausgefuehrt hat. Die REST-API ist auch kein voller Ersatz: /variables/local gibt HTTP 403, die
Token-Klarnamen fehlen dann komplett.
Rueckfallweg: Pflichtschritt F.1 macht der Orchestrator
Laesst sich MCP im Subagenten nicht herstellen, erhebt der Orchestrator die Figma-Rohdaten selbst — er hat MCP — und legt sie als Verifikationsdatei ab:
tmp/issue-grundlage/figma<N>-mcp-verify.md
Mindestinhalt, jeweils mit dem verwendeten Tool-Namen als Herkunft:
get_metadataauf der Components-Page — vollstaendig: jede gefundene Komponente mit Node-ID, Typ, allen Variant-Properties samt Optionen und Default. Das ist das Inventar fuer Pflichtschritt F.2/F.3; den verwendeten Erhebungsweg nennen.get_variable_defs(<Hauptnode>)und je relevanter Variante — Token-Klarnamen mit Werten. Ohne diesen Aufruf fehlen dem Dokument die Token-Namen (/variables/localder REST-API ist 403-gesperrt, liefert also keinen Ersatz).- Kurze, belastbare Schlussfolgerungen aus dem Inventar (welche Variante welches AK belegt, welche Komponente trotz Set nirgends instanziiert ist, welche Komponente auf einer Archiv-Page liegt).
Der Weg ist ausdruecklich der Rueckfall, nicht der Normalfall: der Analyst soll Figma selbst lesen, weil er dabei Fragen stellen kann, die im Voraus niemand kennt. Wird die Datei gebraucht, gehoert der Grund in Abschnitt 11 des Analysedokuments.
Diese Datei wird beiden Analysten im Prompt genannt. Der Claude-Subagent behandelt sie als
Primaerbeleg (eigener Marker, z. B. [MCP]) und darf Pflichtschritt F damit als erfuellt
ansehen; codex ruft die MCP-Tools zusaetzlich selbst auf (eigener Prozess, eigene MCP-Verbindung)
und nutzt die Datei als Gegenprobe. Fehlt die Datei, ist der Subagent angewiesen, das zu melden
statt auf Sekundaerquellen auszuweichen.
Phase 3 — Analyst 2: codex-CLI (gpt-5.6-sol / medium)
Kann parallel zu Phase 2 starten. Fuer Binary-Discovery, Update und die Startregeln
gilt unveraendert .claude/skills/super-review/references/codex-cli.md — dort nachlesen und nicht
neu erfinden. Kurzfassung: codex liegt nicht zwingend im PATH (macOS:
/opt/homebrew/bin/codex; Windows: Pfad aus ~/.codex/config.toml), vor dem Lauf aktualisieren,
ein fehlgeschlagenes Update ist kein Abbruch. <codex> steht unten fuer den gefundenen vollen
Pfad.
RUST_LOG=info <codex> exec \
  --json \
  -m gpt-5.6-sol \
  -c model_reasoning_effort="medium" \
  --sandbox workspace-write \
  --skip-git-repo-check \
  "Erstelle ein Grundlagendokument fuer das GitLab-Work-Item \
https://git.office.brand-ad.de/guardops/issues/-/work_items/<N>. Lies die Datei \
.agents/skills/issue-grundlage/SKILL.md im aktuellen Repository und befolge ihren Abschnitt \
'Pflichtschritt F', den 'Analysekatalog' (A1-A9, einschliesslich A6b) und die 'Verbindliche \
Berichtsstruktur' \
VOLLSTAENDIG. Lies ausserdem .agents/skills/figma-desktop/SKILL.md vollstaendig und verwende \
ausschliesslich den lokalen MCP-Namespace mcp__figma_desktop__ fuer Figma. Die Anforderungen \
liest du ausschliesslich aus dem Snapshot \
tmp/issue-grundlage/issue<N>.md (Beschreibung, Tasks UND Kommentare) - lade nichts aus GitLab nach. \
Das Figma-Design analysierst du mit dem lokalen figma-desktop MCP. Seine Tools koennen deferred \
sein: Suche vor einer Nichtverfuegbarkeitsmeldung im Runtime-Tool-Katalog nach \
mcp__figma_desktop__. Verwende die aktive Desktop-Datei und diese Nodes: <FIGMA-URLS> \
(Quellen-fileKey <FILEKEY>, Node-IDs <NODE-IDS>). Sende an figma-desktop kein fileKey, sondern \
nodeId und die vom konkreten Tool unterstuetzten Parameter. Nutze weder den gehosteten \
mcp__codex_apps__figma_-Namespace noch Web-Browsing oder die Figma-REST-API. Pflichtschritt F ist \
nicht optional: eine Komponenten-Instanz zeigt nur ihren eingestellten Variant-State, darum \
get_metadata auf die 'Components'-Page aufrufen, jede Instanz dagegen matchen und JEDE Komponente \
in der Tabelle 4.2 disponieren; figma-desktop bietet \
list_file_components_for_code_connect nicht an. Vermerke den Erhebungsweg in Abschnitt 11. Eine 'Luecke im \
Figma' darfst du erst behaupten, nachdem dieser Lookup nichts ergeben hat. Bestandscode DARFST \
und SOLLST du lesen: backend/src, frontend/src, Tests, Build- und Konfigurationsdateien sowie git \
log. Erweitert das Work Item ein bestehendes Backend-Feature oder eine bestehende UI, ist die \
Bestandsanalyse A6b PFLICHT - Abschnitt '6b. Bestandsanalyse' mit je einer Zeile pro AK, \
Einstufung neu/Wiederverwendung/Erweiterung/Aenderung/unklar und Beleg als Pfad:Zeile. Gibt es \
keinen Bestandsbezug, begruende das in 6b in einem Satz samt der erfolglosen Suchbegriffe. \
Schreibe keinen Implementierungsplan und entwirf in 6b keine Loesung - nur den Befund. Aendere KEINE Datei ausser \
deiner Ergebnisdatei tmp/item<N>-gpt5.6-sol.md und nimm nichts in Git auf. Schreibe NICHT nach \
docs/ - das Verzeichnis ist allein dem finalen Dokument vorbehalten, das ein anderer Agent \
erstellt." \
  < /dev/null > tmp/issue-grundlage/codex<N>.log 2>&1
Mit timeout: 900000, run_in_background: true und — auf macOS/Windows —
dangerouslyDisableSandbox: true starten, sonst findet die Bash-Sandbox die codex-Binary nicht.
< /dev/null ist Pflicht, nicht Kosmetik. codex exec liest beim Start zusaetzlichen Input von
stdin („Reading additional input from stdin…”). Wird es aus einem Tool-Aufruf gestartet und ist
stdin eine offene Pipe oder ein Terminal-Handle, wartet es unbegrenzt: keine einzige Ausgabezeile,
CPU-Zeit bleibt bei ~0,06 s, und der Lauf endet erst im Timeout. Das ist ein echter Haenger und
sieht einem Modell-Stall zum Verwechseln aehnlich.
Ausgabe in eine Datei umleiten, niemals nach | tail -n. Eine Pipe in tail puffert die
gesamte Ausgabe bis EOF — die Logdatei bleibt waehrend des ganzen Laufs leer, der Fortschritt ist
also nicht beobachtbar. Fortschritt stattdessen mit tail bzw. grep -c "mcp:" auf der
Logdatei pruefen.
So unterscheidet man Arbeit von Haenger: Ein laufender codex erzeugt stetig neue Zeilen in der
Logdatei (bei Figma-Arbeit mcp: figma-desktop/... started). Mehrere Minuten ohne neue Zeile sind
bei nachdenklichen Phasen normal und kein Stall — eine von Anfang an leere Logdatei bei
~0 s CPU dagegen schon.
Platzhalter im Prompt: <FIGMA-URLS> sind die vollstaendigen figma.com/design/...?node-id=…
-URLs aus Phase 1 (alle, komma-getrennt); sie belegen die Quelldatei und erlauben den Abgleich mit
dem in Figma Desktop aktiven Dokument. <FILEKEY> bleibt als Quellenbeleg fuer das Ergebnis,
<NODE-IDS> liefert die Werte fuer die lokalen Tool-Aufrufe. Pflichtschritt F verwendet in Codex
die Components-Page der aktiven Datei und benoetigt dafuer keinen fileKey-Toolparameter.
Die lokale Tool-Vorgabe nicht zu einer allgemeinen „installed Figma integration” abschwaechen.
Der Codex-Lauf muss .agents/skills/figma-desktop/SKILL.md lesen, den exakten Namespace
mcp__figma_desktop__* entdecken und verwenden. Ein Ergebnis aus dem gehosteten Figma-Plug-in,
Web-Browsing oder der REST-API erfuellt Pflichtschritt F nicht.
Ist codex nach vollstaendiger Discovery nicht verfuegbar oder bricht ab: nicht abbrechen, sondern
tmp/item<N>-gpt5.6-sol.md mit „codex-Analyse nicht verfuegbar” plus Fehlerursache fuellen, den
Nutzer informieren und in Phase 5 mit der einen vorhandenen Analyse weiterarbeiten — das Enddokument
muss dann im Kopf ausweisen, dass es nicht doppelt belegt ist.
Phase 4 — Barriere
Erst weiter, wenn beide Dateien existieren, nicht leer sind und die Abschnitte 0–11 der
Berichtsstruktur enthalten. Zusaetzlich pruefen, ob Abschnitt 4.2 (Varianten-Disposition) in beiden
Dateien vorhanden und gefuellt ist — fehlt sie, ist die betroffene Analyse laut Pflichtschritt F
unvollstaendig; das im Kopf des Hauptdokuments vermerken, weil es die Konsens-Zaehlung verzerrt.
Ebenso pruefen, ob Abschnitt 6b vorhanden ist: entweder mit Zeilen samt Pfad:Zeile-Belegen
oder mit der Begruendung, warum es keinen Bestandsbezug gibt. Fehlt 6b ganz, ist die Analyse
unvollstaendig — auch das im Kopf vermerken.
Phase 5 — Zusammenfuehren (Subagent)
Einen Subagenten mit subagent_type: "issue-grundlage-merger" starten (Opus 5 / Medium,
.claude/agents/issue-grundlage-merger.md). Er liest nur die zwei Analyse-Dokumente — er prueft
weder Issue noch Figma nach und fuehrt keine dritte Analyse durch. Der Prompt uebergibt <N>, die
zwei Quellpfade und alle drei Zielpfade (docs/item<N>-final.md,
docs/item<N>-widersprueche.md, docs/item<N>-klaerung.md).
Der Merger liefert Teil-Dateien, der Orchestrator fuegt sie zusammen. Das Enddokument wird 60–200 KB gross und passt nicht in einen
Write: der Lauf reisst die Ausgabegrenze und haengt dann in endlosen Textrunden. Belegt am 2026-08-11 zweimal — der erste Lauf brach nach Abschnitt 4.3.8 ab und produzierte 30 Minuten Turns ohne einen einzigen Tool-Aufruf.
Editist kein Ausweg: es ist in Subagenten dieser Umgebung gesperrt („Edit is disabled for this session, in subagents as well as here”), obwohl es in der Tool-Liste steht — es in dietools:-Zeile aufzunehmen aendert daran nichts. Der Merger schreibt daher mehrere Dateien untertmp/und nennt sie in seiner Abschlussmeldung:
Teil-Datei unter tmp/Inhalt Ziel in docs/item<N>-final.teil1.mdAbschnitte 0, 0b, 1–4 item<N>-final.mditem<N>-final.teil2a.mdAbschnitte 5, 6 und 6b item<N>-final.mditem<N>-final.teil2b.mdAbschnitte 7, 8, die Verweis-Stubs 9 und 10, 11, 12 item<N>-final.mditem<N>-widersprueche.mdAbschnitt 9 vollstaendig item<N>-widersprueche.mditem<N>-klaerung.mdAbschnitt 10 vollstaendig item<N>-klaerung.mdDer Orchestrator baut daraus die drei Enddokumente:
cat tmp/item<N>-final.teil1.md tmp/item<N>-final.teil2a.md tmp/item<N>-final.teil2b.md > docs/item<N>-final.md
cp  tmp/item<N>-widersprueche.md docs/item<N>-widersprueche.md
cp  tmp/item<N>-klaerung.md      docs/item<N>-klaerung.md
Werden die Widerspruchs- oder die Klaerungsliste selbst zu gross fuer einen
Write, splittet der Merger sie ebenfalls (item<N>-klaerung.teil1.md,…teil2.md, …) und nennt die Reihenfolge; der Orchestrator haengt sie dann genauso mitcatzusammen.Bricht ein Lauf trotzdem mittendrin ab: nicht von vorn starten. Vorhandene Teile sichern und einen Fortsetzungslauf beauftragen, der sie liest und nur die fehlenden Abschnitte als neue Teil-Datei schreibt. Ein Neustart wuerde die Klaerungsliste neu durchnummerieren, womit alle
U-Verweise im schon geschriebenen Teil falsch werden — die Nummerierung aus Abschnitt 0b ist die Vorgabe.
Auftrag:
- Gemeinsamkeiten zusammenfuehren: Aussagen, die beide Dokumente inhaltlich gleich treffen,
werden ein Eintrag, ueber die AK-ID verknuepft (bei abweichender Formulierung ueber den
Wortlaut aus dem Issue). Jeder Eintrag ist mit
[beide]markiert. - Einseitige Punkte uebernehmen, nicht wegkuerzen: was nur ein Dokument enthaelt, kommt mit
[nur Opus 5]bzw.[nur gpt-5.6-sol]ins Enddokument. Das gilt fuer AK, Figma-Nodes, Varianten-Zeilen, Detailvorgaben, Scope-Kandidaten und offene Punkte gleichermassen. - Widersprueche zwischen den Dokumenten in das Widerspruchsdokument, mit beiden Aussagen im
Wortlaut, den jeweiligen Belegen (Node-ID / Issue-Stelle) und der Auswirkung. Jeder solche
Widerspruch wird zusaetzlich als Klaerungspunkt
U…gefuehrt — der Nutzer muss ihn entscheiden; der Merger entscheidet nicht selbst und mittelt nicht. - Klaerungsliste vereinen und durchnummerieren (
U1,U2, …), Duplikate zusammenfuehren, die Herkunft je Punkt nennen. Diese Liste ist das Arbeitsergebnis fuer den Nutzer; sie steht ausformuliert indocs/item<N>-klaerung.mdund zusaetzlich als Kurzliste in Abschnitt 0b des Hauptdokuments. - Vollstaendigkeit: jede AK-Zeile, jede Node-ID, jede Bestandszeile aus 6b und jeder offene
Punkt aus beiden Dokumenten muss in einem der drei Enddokumente wiederzufinden sein. Stufen die
Analysten dasselbe AK unterschiedlich ein (etwa
neugegenErweiterung), stehen beide Einstufungen mit ihrem jeweiligen Beleg in der Zeile, und der Fall wird zusaetzlich als Widerspruch 9.2 gefuehrt. Der Merger liest keinen Quellcode nach, um das zu entscheiden. - Die drei Dokumente verlinken: das Hauptdokument verweist an den Stellen 9 und 10 auf die
ausgelagerten Dokumente, beide ausgelagerten Dokumente verweisen im Kopf zurueck auf das
Hauptdokument. Relative Links ohne Verzeichnisanteil (
item<N>-klaerung.md), weil alle drei Dateien indocs/liegen.
Hauptdokument docs/item<N>-final.md mit dieser Gliederung:
# Grundlagendokument (final) Work Item <N> — „<Titel>"
> Status: ENTWURF — erst nach Klaerung aller Punkte in [item<N>-klaerung.md](item<N>-klaerung.md) Grundlage fuer den Implementierungsplan.
> Ausgelagert: [Widersprueche (9)](item<N>-widersprueche.md) · [Offene Punkte (10)](item<N>-klaerung.md)

## 0. Kopf   (Quellen, Analysten + ob doppelt belegt, fileKey, Nodes, Datum, Zahlen)
## 0b. Klaerungsliste — Kurzform   (U1…Un als Checkliste, je eine Zeile)
## 1. User Story und Ziel
## 2. Anforderungen und Akzeptanzkriterien          (je Zeile Herkunftsmarker)
## 3. Tasks
## 4. Figma-Inventar (4.1 Frames · 4.2 Varianten-Disposition · 4.3 Design-Specs)
## 5. Zuordnung AK ↔ Figma                          (Status je AK; bei Uneinigkeit beide Status)
## 6. Detailspezifikation je AK
## 6b. Bestandsanalyse — Neu, Wiederverwendung, Aenderung   (je AK eine Zeile; bei Uneinigkeit beide Einstufungen)
## 7. Im Figma vorhanden, im Issue nicht gefordert
## 8. Im Issue gefordert, im Figma nicht auffindbar
## 9. Widersprueche → [item<N>-widersprueche.md](item<N>-widersprueche.md)
- Inhaltlich (9.1): <n> · Analyse ↔ Analyse (9.2): <n> · davon als Klaerungspunkt gefuehrt: <n>
## 10. Offene Punkte — Klaerung durch den Nutzer → [item<N>-klaerung.md](item<N>-klaerung.md)
- <n> Punkte (U1…Un); Kurzliste in Abschnitt 0b
## 11. Vollstaendigkeitspruefung und Annahmen
## 12. Uebersichtstabelle
| AK-ID | Kurztext | Node-ID | Status | Opus 5 | gpt-5.6-sol | offen (U) |
## 13. Aufgenommene TODOs (Phase 5b)
| TODO | Quelle (Datei:Zeile) | Bezug (AK-ID) | Entscheidung des Nutzers |
Die Abschnitte 9 und 10 bleiben als Ueberschrift mit Kurzzahlen und Link im Hauptdokument stehen — die Nummerierung 0–12 bleibt damit lueckenlos, und wer das Hauptdokument liest, sieht auf einen Blick, wie viele Widersprueche und offene Punkte es gibt.
Ausgelagertes Dokument docs/item<N>-widersprueche.md:
# Widersprueche — Grundlagendokument Work Item <N> — „<Titel>"
> Abschnitt 9 des Grundlagendokuments [item<N>-final.md](item<N>-final.md). Stand: <YYYY-MM-DD>.

## 9.1 Issue ↔ Figma / Issue ↔ Issue / Figma ↔ Figma   (aus beiden Analysen)
| # | Art | Seite A (Beleg) | Seite B (Beleg) | Auswirkung | Klaerungspunkt |

## 9.2 Analyse ↔ Analyse — Opus 5 gegen gpt-5.6-sol    (vom Nutzer zu entscheiden)
| # | Aussage Opus 5 (Wortlaut + Beleg) | Aussage gpt-5.6-sol (Wortlaut + Beleg) | Auswirkung | Klaerungspunkt |
Ausgelagertes Dokument docs/item<N>-klaerung.md:
# Offene Punkte — Klaerung durch den Nutzer — Work Item <N> — „<Titel>"
> Abschnitt 10 des Grundlagendokuments [item<N>-final.md](item<N>-final.md). Kurzliste dort in
> Abschnitt 0b; Widersprueche in [item<N>-widersprueche.md](item<N>-widersprueche.md).
> Stand: <YYYY-MM-DD>.

### U1 — <Frage>
- **Bezug:** …   (AK-ID / Node-ID / Issue-Stelle; bei Analyse-Widerspruch die Nummer aus 9.2)
- **Herkunft:** [beide] / [nur Opus 5] / [nur gpt-5.6-sol]
- **Warum blockierend:** …
- **Optionen:** …
- **Empfehlung:** …
Die U-Nummerierung ist ueber alle drei Dokumente hinweg dieselbe: sie wird in Abschnitt 0b
des Hauptdokuments vergeben, in item<N>-klaerung.md ausformuliert und aus dem
Widerspruchsdokument nur referenziert.
Abschnitt 13 entsteht erst in Phase 5b und bleibt mit dem Vermerk kein passender TODO gefunden
stehen, wenn der Abgleich leer ausging — so ist belegt, dass er stattgefunden hat.
Bei uneinheitlichem Status beide Werte nennen (z. B. belegt (Opus5) / teilweise belegt
(gpt5.6-sol)) und nicht mitteln.
Phase 5b — TODO-Abgleich (Orchestrator, mit Rueckfrage)
Im Repo liegen gesammelte, noch nicht eingeplante Punkte in todo.md-Dateien. Ein neues Work Item
ist die Gelegenheit, die passenden davon mitzunehmen, statt sie ein weiteres Mal zu uebergehen.
-
Alle Dateien einsammeln — auch kuenftige, deshalb suchen statt aufzaehlen:
ls docs/todo.md backend/docs/todo.md frontend/docs/todo.md 2>/dev/null - Jede gefundene Datei ganz lesen und jeden offenen Eintrag (unerledigt, also kein
[x]) gegen das Enddokument halten. Passend ist ein TODO, wenn es dieselbe Komponente, denselben Endpunkt, denselben Screen oder dasselbe AK betrifft wie das Work Item. Reine Themennaehe („auch Frontend”, „auch Tests”) reicht nicht — solche Treffer gar nicht erst vorlegen. - Gibt es Treffer, dem Nutzer jeden einzeln vorlegen: TODO-Text,
Datei:Zeile, das AK, zu dem er passt, und eine Empfehlung mit Begruendung. Dann perAskUserQuestionfragen, welche davon in dieses Work Item aufgenommen werden sollen (Mehrfachauswahl, Optionen mindestensaufnehmen/nicht aufnehmen). Nicht selbst entscheiden und nicht stillschweigend uebernehmen. - Abschnitt 13 an
docs/item<N>-final.mdanhaengen: je Treffer eine Zeile mit der Entscheidung. Aufgenommene TODOs zusaetzlich beim zugehoerigen AK in Abschnitt 6 alsZusaetzlich aus todo.md (<Datei:Zeile>): …vermerken; passt ein aufgenommener TODO zu keinem AK, wird er als eigenesAK-T<x>gefuehrt. - Die
todo.mdselbst bleibt unveraendert. Erledigt ist ein TODO erst, wenn der Code steht — ausgetragen wird er dort, nicht hier.
Keine Treffer: Abschnitt 13 mit kein passender TODO gefunden schreiben und weiter zu Phase 6.
Phase 6 — Bericht an den Nutzer
Kurz zusammenfassen, ohne das Enddokument abzuschreiben: Anzahl AK, davon belegt /
teilweise belegt / im Figma nicht gefunden, Anzahl Widersprueche (getrennt nach inhaltlich und
Analyse-gegen-Analyse), die Klaerungsliste U1…Un als kompakte Aufzaehlung — das ist der Punkt,
an dem der Nutzer arbeitet — und die Dateipfade: docs/item<N>-final.md als Hauptdokument,
docs/item<N>-widersprueche.md und docs/item<N>-klaerung.md als die beiden ausgelagerten
Arbeitslisten, dazu tmp/item<N>-opus5.md und tmp/item<N>-gpt5.6-sol.md als Belege zum
Nachschlagen. Dazu eine Zeile zum TODO-Abgleich: welche TODOs
aufgenommen wurden, welche der Nutzer abgelehnt hat — oder dass keiner passte.
Dann stoppen. Kein Implementierungsplan, keine Codeaenderung, kein Commit. Erst wenn der Nutzer
die offenen Punkte beantwortet hat, werden die Antworten in docs/item<N>-klaerung.md
eingearbeitet, die Kurzliste 0b im Hauptdokument abgehakt und der Status ENTWURF in dessen Kopf
entfernt — und erst danach entsteht daraus der Plan.
Zusammenspiel der Phasen
Phase 0  <N> → Work Item + Tasks (GraphQL-Hierarchie) + alle Kommentare
         → Snapshot tmp/issue-grundlage/issue<N>.md; alte Ergebnisdateien bereinigen
Phase 1  Figma-Link aus Snapshot; fehlt er → NACHFRAGEN (Screenshots gelten nicht)
Phase 2  Opus 5 / Medium          ─┐  gleicher Snapshot, gleicher Katalog,
Phase 3  codex gpt-5.6-sol / medium  ┘  Pflichtschritt F verpflichtend
Phase 4  Barriere: beide Dateien da, Abschnitte 0–11 inkl. 4.2 und 6b vorhanden
Phase 5  Merger-Subagent: tmp/item<N>-opus5.md + tmp/item<N>-gpt5.6-sol.md
         → docs/item<N>-final.md          (Hauptdokument, 0-8 + 11-12 + Links auf 9/10)
         → docs/item<N>-widersprueche.md  (Abschnitt 9)
         → docs/item<N>-klaerung.md       (Abschnitt 10)
         (Gemeinsamkeiten · einseitige Punkte · Widersprueche → Klaerungsliste)
Phase 5b docs/todo.md · backend/docs/todo.md · frontend/docs/todo.md gegen das Work Item
         → passende TODOs dem Nutzer vorlegen (AskUserQuestion) → Abschnitt 13
Phase 6  Kurzbericht + Klaerungsliste + TODO-Entscheidungen an den Nutzer — ENDE

Bestand lesen ja (A6b), aendern nein. Kein Plan. In docs/ landen nur diese drei Dokumente; die beiden
Analysen und der Snapshot bleiben unter tmp/ und werden nicht eingecheckt.